第 27 章:数字钱包
简介
支付平台通常提供钱包服务,允许用户在应用内存放资金,日后再提取。
用户也可以用钱包支付商品和服务,或向其他数字钱包用户转账。这通常比传统支付网络更快、成本更低。
<img src="/images/chapter-27/digital-wallet.png" alt="数字钱包" width="500" />
第一步:理解问题并确定设计范围
- 候选人:是否只考虑数字钱包之间的转账?还需要支持其他操作吗?
- 面试官:目前只考虑数字钱包之间的转账。
- 候选人:系统需要支持多少笔每秒交易?
- 面试官:假设为 100 万 TPS。
- 候选人:数字钱包的正确性要求很严格。可以假设事务保证足够吗?
- 面试官:可以。
- 候选人:需要证明正确性吗?
- 面试官:可以通过对账发现差异,但对账不能解释差异的根本原因。我们希望能够从头重放数据,重建历史。
- 候选人:可用性要求是否为 99.99%?
- 面试官:是。
- 候选人:需要考虑外汇兑换吗?
- 面试官:不需要,不在范围内。
综上,系统需要:
- 支持两个账户之间的余额转账;
- 支持 100 万 TPS;
- 可靠性达到 99.99%;
- 支持事务;
- 支持重放与重建。
粗略估算
部署在云上的传统关系型数据库约可支持 1000 TPS。
要达到 100 万 TPS,需要约 1000 个数据库节点。但每笔转账包含两端的余额变更,因此实际需要支持 200 万次每秒操作。
设计目标之一是提高单节点 TPS,从而减少数据库节点数量。
| 单节点 TPS | 节点数量 |
|---|---|
| 100 | 20,000 |
| 1,000 | 2,000 |
| 10,000 | 200 |
第二步:提出概要设计并达成共识
API 设计
本次设计只需一个接口:
POST /v1/wallet/balance_transfer - transfers balance from one wallet to another请求参数包括 from_account、to_account、amount(用字符串避免精度损失)、currency 和 transaction_id(幂等键)。
响应示例:
{
    "status": "success"
    "transaction_id": "01589980-2664-11ec-9621-0242ac130002"
}
内存分片方案
钱包应用维护每位用户账户的余额。
可用 map<user_id, balance> 表示,并使用内存数据库 Redis 实现。
单个 Redis 节点无法承受 100 万 TPS,因此需要将 Redis 集群划分到多个节点。
分区算法示例:
String accountID = "A";
Int partitionNumber = 7;
Int myPartition = accountID.hashCode() % partitionNumber;
ZooKeeper 可作为高可用配置存储,保存分区数量和 Redis 节点地址。
钱包服务负责执行转账,且本身无状态,因而容易水平扩容:
<img src="/images/chapter-27/wallet-service.png" alt="钱包服务" width="500" />
该方案解决了扩展性问题,却无法原子地完成余额转账。
分布式事务
一种办法是在标准的分片关系型数据库之上使用两阶段提交协议:
<img src="/images/chapter-27/distributed-transactions-relational-dbs.png" alt="关系型数据库中的分布式事务" width="500" />
两阶段提交(2PC)的工作方式:
<img src="/images/chapter-27/2pc-protocol.png" alt="2PC 协议" width="500" />
- 协调者(钱包服务)照常在多个数据库上执行读写。
- 应用准备提交事务时,协调者请求所有数据库进入准备阶段。
- 如果所有数据库都回答“是”,协调者要求它们提交事务。
- 否则,协调者要求所有数据库中止事务。
2PC 的缺点:
- 锁竞争导致性能不佳。
- 协调者是单点故障。
使用 Try-Confirm/Cancel(TC/C)的分布式事务
TC/C 是 2PC 的一种变体,通过补偿事务运作:
- 协调者要求所有数据库为事务预留资源。
- 协调者收集数据库答复:若全部成功,则执行确认;否则执行取消。
TC/C 与 2PC 的一个重要区别是:2PC 完成一笔事务,而 TC/C 包含两笔独立事务。
TC/C 分阶段执行如下:
| 阶段 | 操作 | A | C |
|---|---|---|---|
| 1 | Try(尝试) | 余额变更:-$1 | 不执行操作 |
| 2 | Confirm(确认) | 不执行操作 | 余额变更:+$1 |
| Cancel(取消) | 余额变更:+$1 | 不执行操作 |
阶段 1——尝试:
<img src="/images/chapter-27/try-phase.png" alt="尝试阶段" width="500" />
- 协调者在 A 的数据库中开启本地事务,将 A 的余额减少 $1。
- C 的数据库收到空操作(NOP),不更改数据。
阶段 2a——确认:
<img src="/images/chapter-27/confirm-phase.png" alt="确认阶段" width="500" />
- 如果两个数据库都回答“是”,则进入确认阶段。
- A 的数据库收到 NOP;C 的数据库通过本地事务将 C 的余额增加 $1。
阶段 2b——取消:
<img src="/images/chapter-27/cancel-phase.png" alt="取消阶段" width="500" />
- 如果阶段 1 的任一操作失败,就进入取消阶段。
- A 的数据库将 A 的余额增加 $1;C 的数据库收到 NOP。
2PC 与 TC/C 的比较:
| 第一阶段 | 第二阶段:成功 | 第二阶段:失败 | |
|---|---|---|---|
| 2PC | 事务尚未完成 | 提交或取消所有事务 | 取消所有事务 |
| TC/C | 各事务已经提交或取消 | 根据需要执行新事务 | 撤销已提交的事务 |
TC/C 也称为通过补偿实现的分布式事务,整体流程由业务逻辑处理。
TC/C 的其他特点:
- 只要数据库支持事务,就不依赖特定数据库。
- 分布式事务的细节和复杂性需要在业务逻辑中处理。
TC/C 的故障模式
如果协调者在执行过程中故障,必须恢复中间状态。可以在数据库分片中维护阶段状态表,并与业务变更原子更新:
<img src="/images/chapter-27/phase-status-tables.png" alt="阶段状态表" width="500" />
该表记录:
- 分布式事务的 ID 和内容;
- 尝试阶段的状态——未发送、已发送、已收到响应;
- 第二阶段的名称——确认或取消;
- 第二阶段的状态;
- 乱序标记(下文说明)。
TC/C 的一个注意点是:分布式事务进行期间,账户状态会暂时不一致:
<img src="/images/chapter-27/unbalanced-state.png" alt="暂时不平衡的状态" width="500" />
只要系统总能从该状态恢复,且用户无法利用中间状态花费资金,这种短暂不一致可以接受。始终先扣款、再入账即可保证这一点。
| 尝试阶段的选择 | 账户 A | 账户 C |
|---|---|---|
| 选择 1 | -$1 | NOP |
| 选择 2(无效) | NOP | +$1 |
| 选择 3(无效) | -$1 | +$1 |
选择 3 无效,因为不借助 2PC 就无法保证跨数据库事务原子执行。
还需处理乱序执行这一边界情况:
<img src="/images/chapter-27/out-of-order-execution.png" alt="乱序执行" width="500" />
数据库可能在收到尝试操作之前先收到取消操作。可在阶段状态表中添加乱序标记:收到尝试操作时先检查标记,若已设置,则返回失败。
使用 Saga 的分布式事务
Saga 是微服务架构中实现分布式事务的另一种常见模式。
工作方式:
所有操作按顺序排列,每项操作在自己的数据库中独立执行。
按从前到后的顺序执行操作。
某项操作失败时,整个流程通过补偿操作逐步回滚到起点。
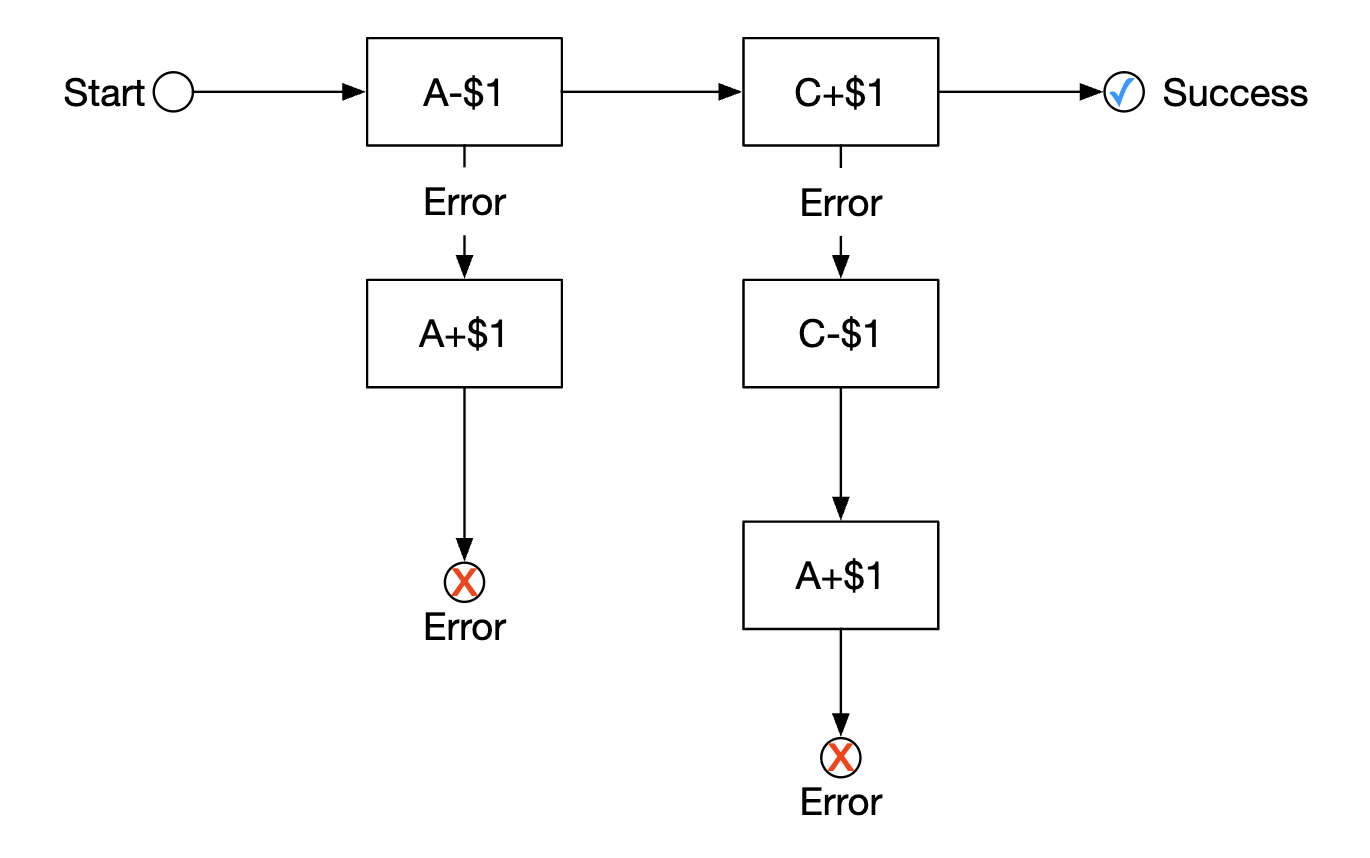
如何协调流程?有两种方法:
- **协同编排(Choreography):**Saga 中的各服务订阅相关事件,并各自完成其职责。
- **集中编排(Orchestration):**由单个协调者按正确顺序指示各服务工作。
协同编排的挑战是业务逻辑分散在多个异步通信的服务中。集中编排更容易管理复杂性,因此数字钱包系统通常更适合采用它。
TC/C 与 Saga 的比较:
| TC/C | Saga | |
|---|---|---|
| 补偿操作 | 取消阶段 | 回滚阶段 |
| 集中协调 | 是 | 是(集中编排模式) |
| 操作执行顺序 | 任意 | 线性 |
| 能否并行执行 | 能 | 不能(线性执行) |
| 是否会观察到部分不一致状态 | 会 | 会 |
| 由应用还是数据库处理 | 应用 | 应用 |
主要区别在于 TC/C 可以并行化,因此选择取决于延迟要求;如果需要低延迟,应选择 TC/C。
无论选哪种方案,都还需要审计能力,并能重放历史以从故障状态恢复。
事件溯源
现实中的数字钱包应用可能接受审计,需要回答:
- 我们能否知道任意时刻的账户余额?
- 如何知道历史余额和当前余额正确?
- 代码修改后,如何证明系统逻辑仍然正确?
事件溯源有助于回答这些问题。
它包含四个概念:
**命令:**来自现实世界的预期动作,如从账户 A 向 B 转账 $1。命令需要全局顺序,因此放入 FIFO 队列。
- 与事件不同,命令可能因 I/O 或无效状态等原因失败,也可能具有不确定性。
- 命令可产生零个或多个事件。
- 生成事件时可能依赖外部 I/O 等不确定因素,后文会再讨论。
**事件:**系统中已经发生的历史事实,如“从 A 向 B 转账 $1”。
- 与命令不同,事件是已经发生的事实。
- 事件也需要保持顺序,因此放入 FIFO 队列。
**状态:**事件造成的变化,例如保存账户及其余额的键值存储。
**状态机:**驱动事件溯源流程,主要负责验证命令及应用事件来更新状态。
- 状态机必须是确定性的,因此不能读取外部 I/O 或依赖随机性。
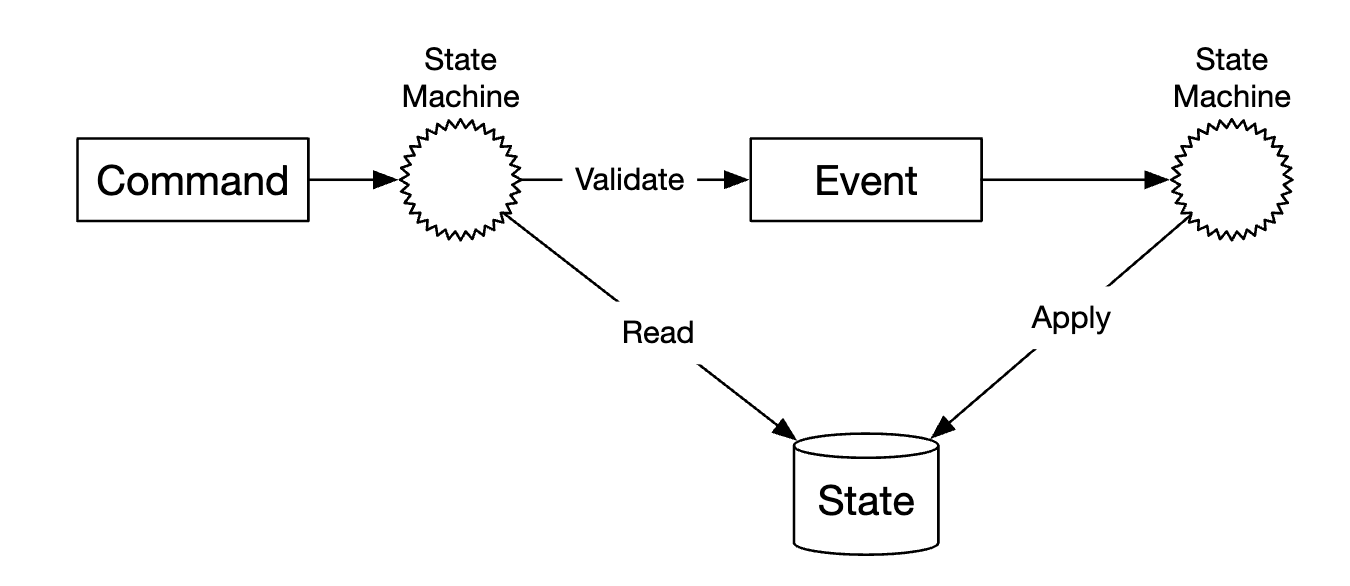
事件溯源的动态过程如下:
<img src="/images/chapter-27/dynamic-event-sourcing.png" alt="事件溯源动态过程" width="500" />
对钱包服务而言,命令就是余额转账请求,可以放入 Kafka 等 FIFO 队列:
<img src="/images/chapter-27/command-queue.png" alt="命令队列" width="500" />
完整流程如下:
<img src="/images/chapter-27/wallet-service-state-macghine.png" alt="钱包服务状态机" width="500" />
- 状态机从命令队列读取命令。
- 从数据库读取余额状态。
- 验证命令;若有效,则为两个账户分别生成事件。
- 读取下一个事件,更新数据库中的余额状态,以应用该事件。
事件溯源的主要优点是可重放性。在此设计中,所有状态更新都作为不可变的余额变更历史保存。
从头重放事件即可重建历史余额。事件列表不可变、状态机具有确定性,因此任一中间状态都可以重建。
<img src="/images/chapter-27/historical-states.png" alt="历史状态" width="500" />
借助事件溯源,可回答本节开头的审计问题:
- **任意时刻的余额?**从起点重放事件,直到目标时间点。
- **历史余额和当前余额是否正确?**从起点重新计算所有事件以验证。
- **代码修改后逻辑是否仍正确?**用不同版本代码处理同一事件序列,并验证结果一致。
客户端查询余额可采用 CQRS 架构:多个只读状态机依据不可变事件列表查询历史状态:
<img src="/images/chapter-27/cqrs-architecture.png" alt="CQRS 架构" width="500" />
第三步:详细设计
本节探讨性能优化,因为系统仍须达到 100 万 TPS。
高性能事件溯源
第一项优化是将命令和事件保存到本地磁盘,而不是 Kafka 等外部存储。
这可避免网络延迟;由于只进行追加写入,即使使用机械硬盘通常也较快。
第二项优化是将近期命令和事件缓存在内存中,避免从磁盘重新加载。
底层可利用 mmap 实现:数据保存在本地磁盘,同时由内存缓存:
<img src="/images/chapter-27/mmap-optimization.png" alt="mmap 优化" width="500" />
还可以将状态保存在本地文件系统中的 SQLite(一种基于文件的关系型数据库)或 RocksDB。
这里选择 RocksDB,因为它使用针对写入优化的日志结构合并树(LSM);读取性能则通过缓存优化。
<img src="/images/chapter-27/rocks-db-approach.png" alt="RocksDB 方案" width="500" />
为加快重建,可定期将快照保存到磁盘,避免每次都从起点重放。快照可作为大型二进制文件存入 HDFS 等分布式文件存储:
<img src="/images/chapter-27/snapshot-approach.png" alt="快照方案" width="500" />
可靠的高性能事件溯源
以上优化使服务变为有状态,因此需要复制机制来保证可靠性。
先分析哪些数据必须高度可靠:
- 状态和快照都可由事件列表重建,因此只需保证事件列表可靠。
- 命令具有不确定性,不能假设总能从命令列表重新生成相同的事件列表。
- 因而必须重点保证事件列表的可靠性。
为此,需要跨节点复制事件列表,并保证:
- 数据不丢失;
- 各副本日志文件中的数据相对顺序相同。
可以使用 Raft 等共识算法。
在 Raft 中,领导者主动处理工作,跟随者保持被动。领导者故障时,某个跟随者接任。只要超过半数节点仍运行,系统就能继续工作。
<img src="/images/chapter-27/raft-replication.png" alt="Raft 复制" width="500" />
所有节点均依据事件列表更新状态;Raft 保证领导者和跟随者拥有相同的事件列表。
分布式事件溯源
目前的设计兼具高单节点性能与可靠性,但仍有局限:
- 单个 Raft 组的容量有限,最终需要分片并实现分布式事务。
- 在 CQRS 架构中,请求响应流程较慢;客户端需要定期轮询,才能得知钱包何时更新。
轮询并非实时,用户可能很久之后才得知余额变化;如果轮询过于频繁,又会压垮查询服务:
<img src="/images/chapter-27/polling-approach.png" alt="轮询方案" width="500" />
为减轻系统负载,可以引入反向代理,代替用户发送命令并轮询响应:
<img src="/images/chapter-27/reverse-proxy.png" alt="反向代理" width="500" />
反向代理可以通过一次请求获取多个用户的数据,从而减轻负载,但仍无法解决实时收到结果的需求。
最后,让只读状态机在结果可用时主动推送给反向代理,使用户感觉更新是实时发生的:
<img src="/images/chapter-27/push-state-machines.png" alt="状态机推送" width="500" />
为进一步扩容,可将系统分成多个 Raft 组,再通过编排器使用 TC/C 或 Saga 在组间实现分布式事务:
<img src="/images/chapter-27/sharded-raft-groups.png" alt="分片 Raft 组" width="500" />
最终系统中,一次余额转账请求的生命周期示例:
- 用户 A 向 Saga 协调者发送分布式事务,包含
A-1和C+1两项操作。 - 协调者在阶段状态表中创建记录,跟踪事务状态。
- 协调者确定命令应发送到哪些分区。
- 分区 1 的 Raft 领导者收到
A-1命令,验证并转换为事件,再复制到该 Raft 组的其他节点。 - 事件结果同步到读取状态机,后者向协调者推送响应。
- 协调者记录该操作成功,继续执行
C+1。 - 第二项操作以类似方式执行:确定分区、发送并执行命令,由读取状态机推送响应。
- 协调者记录第二项操作成功,最后通知客户端结果。
第四步:总结
设计的演进过程:
- 首先使用内存中的 Redis,但它并非持久存储。
- 接着采用关系型数据库,并通过 2PC、TC/C 或分布式 Saga 执行分布式事务。
- 然后引入事件溯源,使所有操作都可审计。
- 起初将数据保存在外部数据库和队列中,但性能不足。
- 随后改用本地文件存储,发挥追加写入的性能,并使用缓存优化读取路径。
- 由于单节点仍存在故障风险,引入 Raft 共识和复制,避免单点故障。
- 同时采用 CQRS 和反向代理,代表用户管理事务生命周期。
- 最后将数据分布到多个 Raft 组,通过 TC/C 或分布式 Saga 编排跨组事务。