第 16 章:附近地点服务
引言
附近地点服务用于查找用户周围的地点,例如餐馆、酒店、加油站等商家。Google Maps 和 Yelp 等应用使用这一功能,帮助用户发现指定半径内的地点。
第 1 步:理解问题并确定范围
功能需求
- 根据用户位置(纬度、经度)和搜索半径搜索商家。
- 允许商家所有者添加、更新或删除商家信息(无需实时生效)。
- 根据请求提供商家详细信息。
非功能需求
- 低延迟:快速响应用户请求。
- 数据隐私:遵守 GDPR 和 CCPA 法规。
- 高可用性:应对繁忙地区高峰时段的流量突增。
粗略估算
- 1 亿日活跃用户。
- 系统中有 2 亿家商家。
- 搜索 QPS 计算:
- 每位用户每天搜索 5 次。
- 搜索 QPS = (100M × 5) / 86,400 ≈ 5,000 QPS。
第 2 步:概要设计
API 设计
搜索附近商家
GET /v1/search/nearby
- 请求参数:
latitude:用户位置的纬度。longitude:用户位置的经度。radius:搜索半径(默认 5000m)。
商家 API
| API 接口 | 说明 |
|---|---|
GET /v1/businesses/{id} | 获取商家详细信息 |
POST /v1/businesses | 添加新商家 |
PUT /v1/businesses/{id} | 更新商家信息 |
DELETE /v1/businesses/{id} | 从系统中删除商家 |
数据模型
- 以下两种常用功能会产生大量读请求,因此 MySQL 等关系型数据库比较合适:
- 搜索附近商家;
- 查看商家详细信息。
数据表结构
- 关键数据表包括商家表和地理空间索引表。
- 商家表存放商家的详细信息。
系统概要架构
系统由两部分组成:位置服务(LBS)和商家服务。
<img src="/images/chapter-16/high-level-design.png" alt="概要设计" width="400" />
- 位置服务(LBS):
- 处理基于位置的搜索请求。
- 只读、无写请求。
- 在人口密集地区的高峰时段,QPS 尤其高;服务本身无状态。
- 商家服务:处理两类请求。
- 商家所有者创建、更新或删除商家信息。
- 顾客查看商家详细信息。
- 负载均衡器:将流量路由到位置服务或商家服务。
- 数据库集群:
- 使用主副本架构处理以读取为主的负载。
- LBS 从副本读到的数据与主库中刚写入的数据可能暂时不同。
- 商家信息不要求实时更新,因此这种短暂不一致可以接受。
第 3 步:查找附近商家的算法
方案 1:二维搜索(朴素方案)
<img src="/images/chapter-16/2d-search.png" alt="二维搜索" width="250" />
最直观的方式是以预设半径画一个圆,再查找圆内所有商家。
SQL 查询:
SELECT business_id, latitude, longitude
FROM business
WHERE (latitude BETWEEN :lat - radius AND :lat + radius)
AND (longitude BETWEEN :long - radius AND :long + radius);
问题:
- 效率低:需要扫描整个数据库。
- 受一维索引限制:纬度或经度索引无法同时高效筛选两个维度。
一种改进是在经度和纬度列上建立索引,但虽然略有改善,查询仍然很慢。
更好的方法
- 前一种方法的问题在于,数据库索引只能加速一个维度的搜索。
- 更好的方法是利用地理空间索引,把二维数据映射到一维。
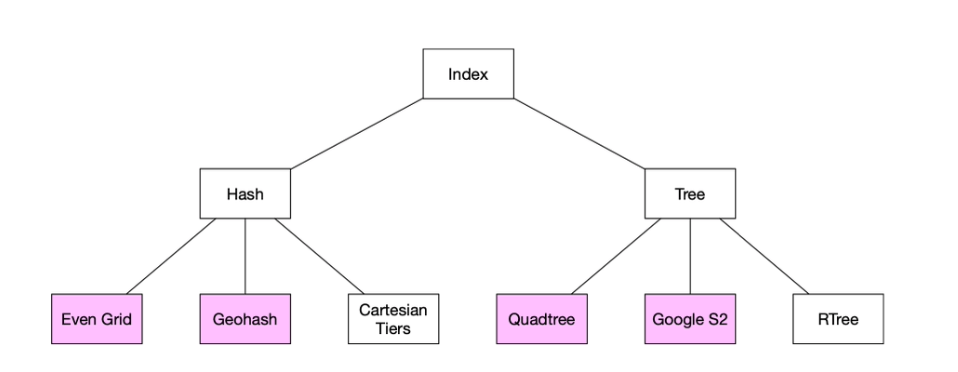
哈希类:均匀网格、Geohash。
树结构:四叉树、Google S2、R 树。
方案 2:均匀网格
<img src="/images/chapter-16/even-grid.png" alt="均匀网格" width="400" />
- 把世界划分成固定大小的网格。
- 问题:商家分布不均,城市密集而乡村稀疏。
方案 3:Geohash
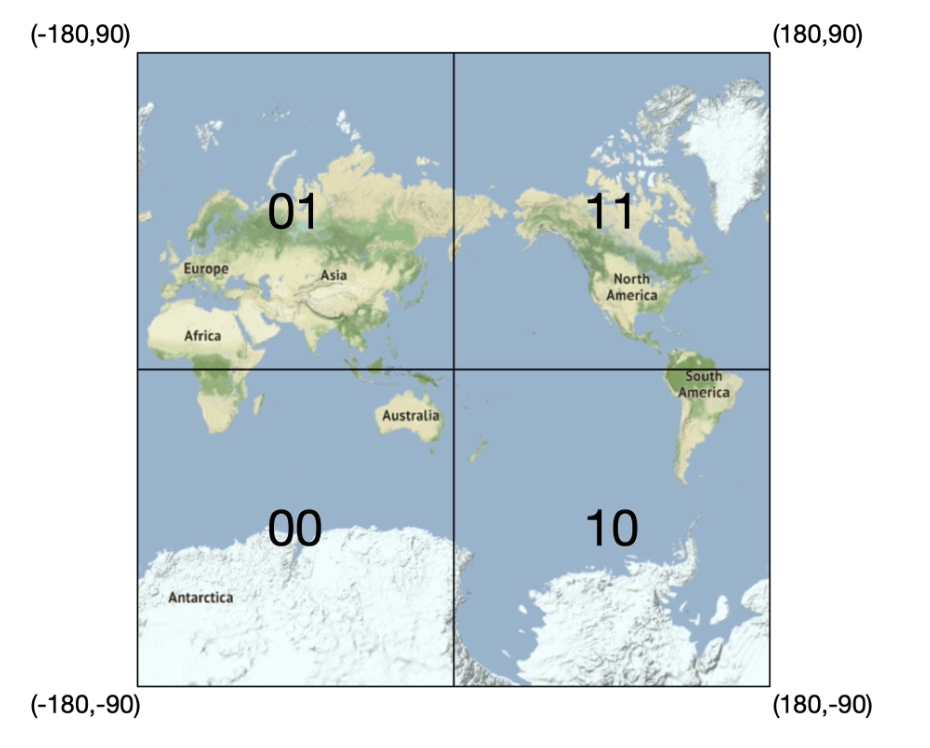
沿本初子午线和赤道把地球划分为四个区域,再把每个网格分为四个更小的网格。
通过交替使用经度位和纬度位表示各个网格。
重复细分过程。
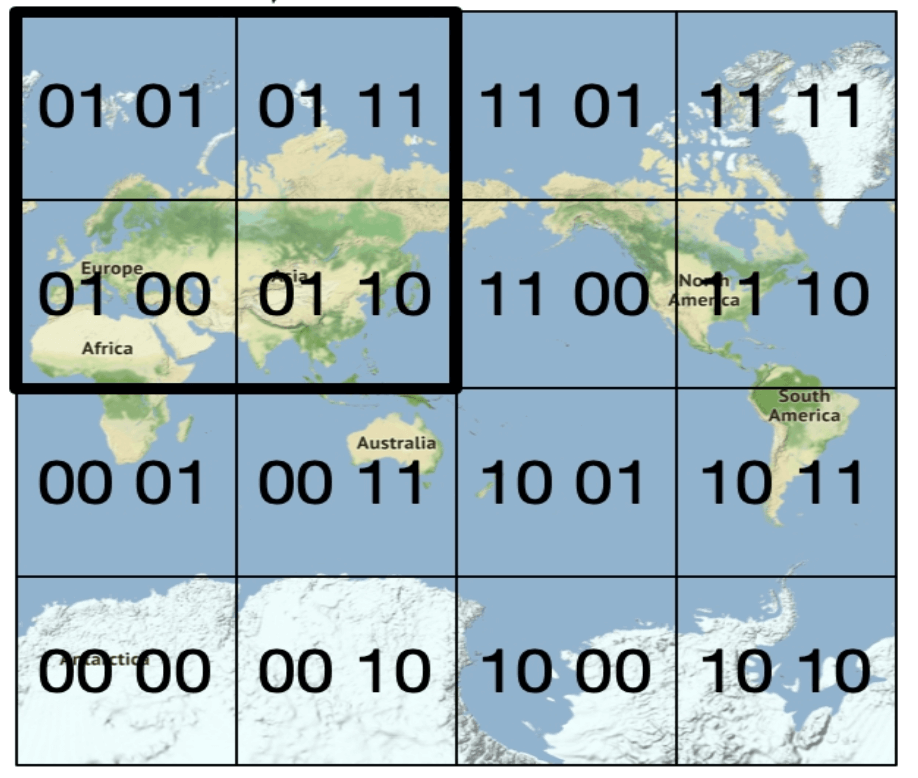
把经纬度编码为一个字母数字字符串,共有 12 个精度级别。
层次化网格结构有利于高效搜索。
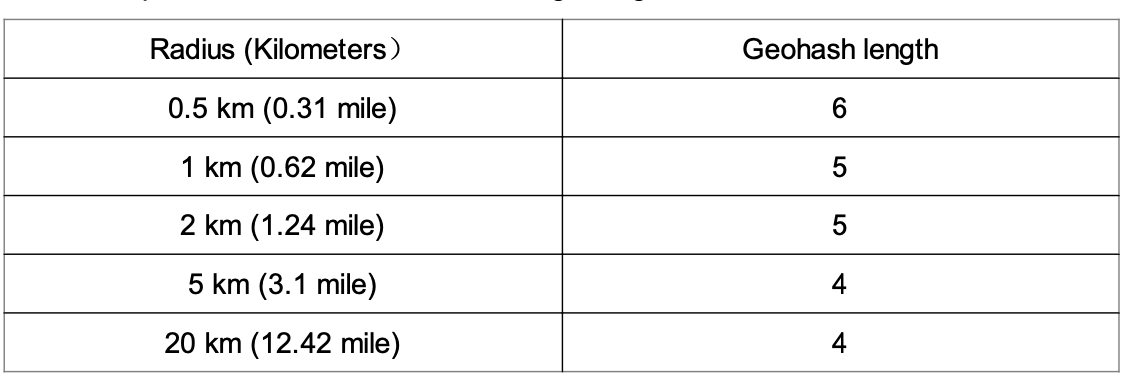
根据下表选择满足搜索半径要求的最短 Geohash 长度。
两个 Geohash 的公共前缀越长,对应的位置通常越近。
挑战:
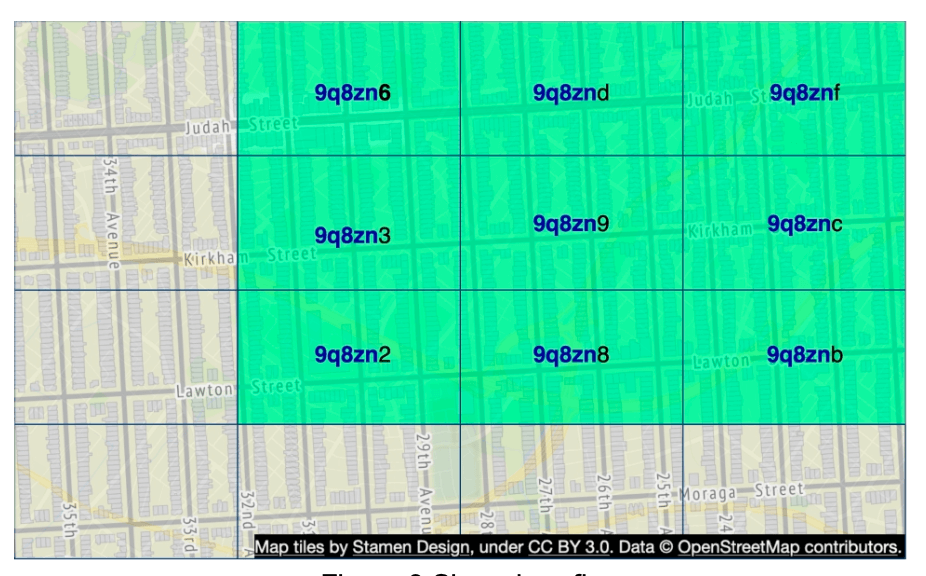
- 边界问题:靠近网格边缘的商家可能被排除。
- 两个地点可能非常近,却完全没有公共前缀(例如位于赤道两侧)。
- 两个地点也可能有较长的公共前缀,却属于不同的 Geohash 网格。
- 解决办法:同时搜索相邻网格。
- 边界问题:靠近网格边缘的商家可能被排除。
方案 4:四叉树
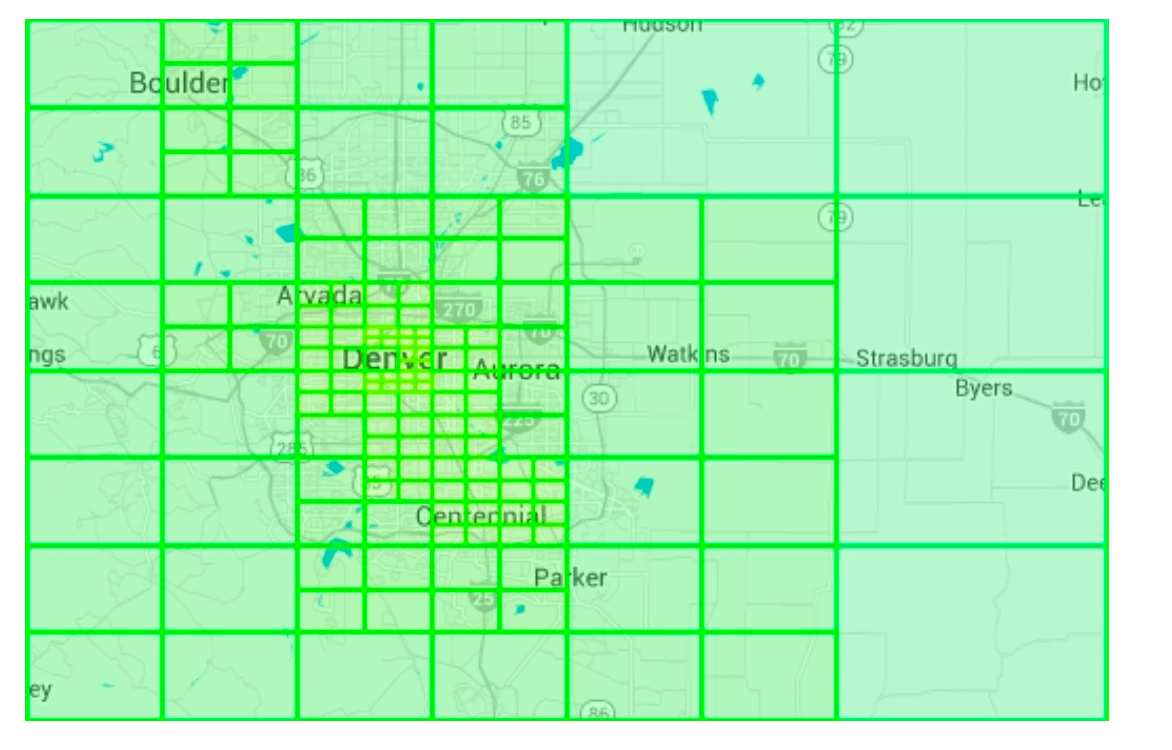
四叉树是一种树形数据结构,递归地把二维空间分成四个象限。每个内部节点恰好有四个子节点,分别表示四个子区域。
四叉树是在每台 LBS 服务器上运行的内存数据结构,并在服务器启动时构建。
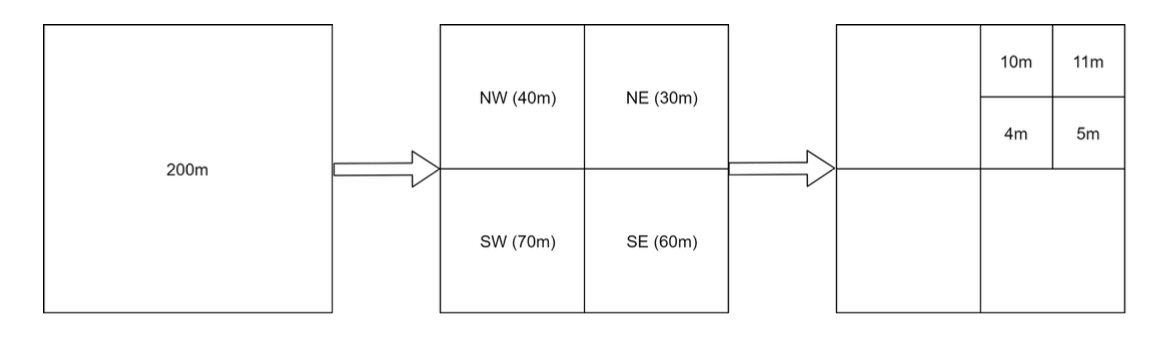
从根节点开始递归划分四个象限,直到没有节点包含超过 x 家商家(此处为 100 家)。
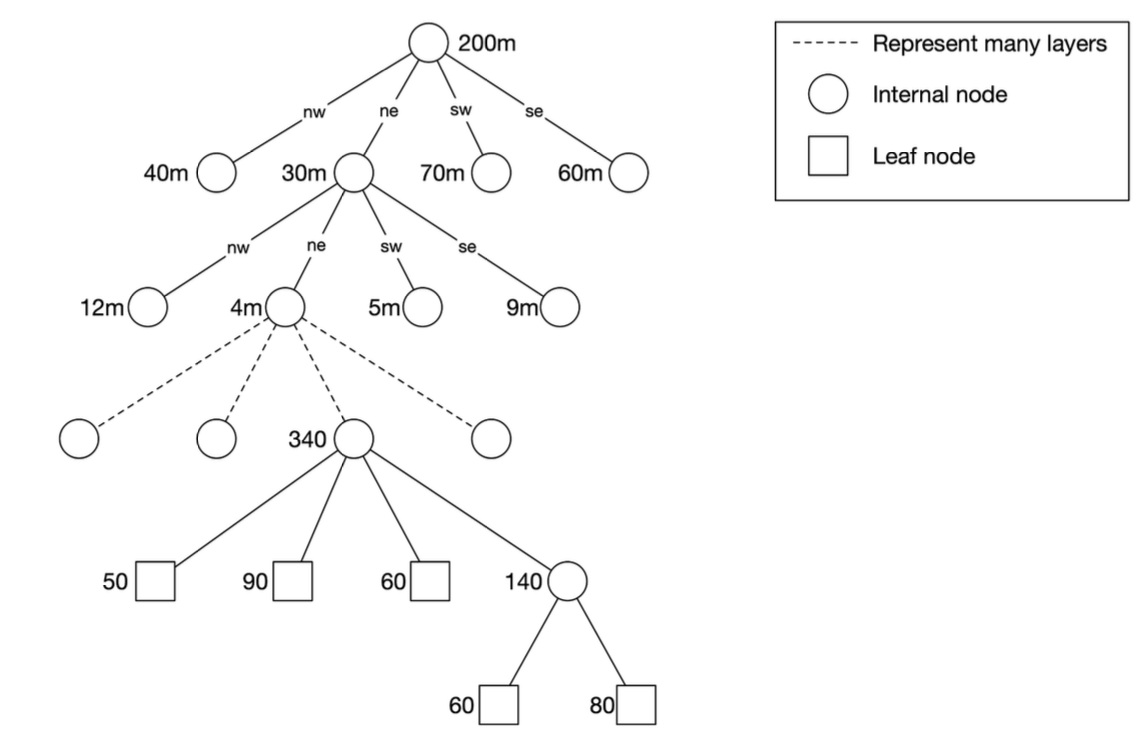
四叉树索引占用的内存不大(通常为 GB 级),一台服务器就能容纳。
建树时间复杂度为 nlogn,可能需要几分钟。
适合高效处理 k 近邻查询,例如查找最近的加油站。
运维方面的考虑
- 对约 2 亿家商家,服务器启动时构建四叉树可能需要几分钟。
- 建树期间服务器无法承接流量,因此新版本应先在部分服务器上逐步发布。
- 更新或新增商家时,最简单的方式是重新构建四叉树,但这会使大量缓存失效。
- 也可以实时更新四叉树,但实现更复杂,需要锁机制。
方案 5:Google S2
它基于希尔伯特曲线将球面映射为一维索引。希尔伯特曲线上相邻的点,在一维空间中也相邻。
<img src="/images/chapter-16/hilbert-curve.png" alt="希尔伯特曲线" width="300" />
<img src="/images/chapter-16/geofence.png" alt="地理围栏" width="355" />
- 使用希尔伯特曲线将地球划分为小单元格。
- 适合地理围栏,因为它可以用不同层级的单元格覆盖任意区域。
- 地理围栏还允许定义围绕目标区域的参数。
- S2 还可以指定最小层级、最大层级和最大单元格数量,无需固定精度。
方案权衡
Geohash
- 易于使用和实现,无需构建或重建树。
- 支持固定半径的搜索结果。
- 更新索引容易。
- 无法根据商家密度动态调整网格大小。
四叉树
- 实现稍难。
- 支持查找最近的 k 家商家。
- 可以根据商家密度动态调整网格大小。
- 更新索引较复杂,可能需要重建整棵树。
第 4 步:数据库扩展与缓存策略
扩展商家表
- 按商家 ID 分片,保证数据均匀分布。
- 每家商家在表中占一行。
| Geohash | 商家 ID |
|---|---|
| 9q9hvu | 343 |
| 9q9hvu | 347 |
| 9q9hvu | 112 |
扩展地理空间索引
- 对 Geohash 表而言,分片可能并不合适。所有数据都可以放进一台服务器,从技术上看没有分片的必要。
- 更好的方法是添加只读副本,分担读取负载。
缓存策略
最直观的缓存键是位置坐标,但存在几个问题:
- GPS 坐标不够精确。
- 用户移动会使坐标改变。
- 因此,更好的缓存键是 Geohash。
| 缓存键 | 缓存值 |
|---|---|
geohash | 该网格内的商家 ID 列表 |
business_id | 商家详情(名称、地址、评价等) |
第 5 步:部署策略与最终架构
区域与可用区
- 将 LBS 和商家服务部署在多个区域。
处理实时更新
- 商家信息更新每天批量处理。
最终系统架构
<img src="/images/chapter-16/final-design.png" alt="最终设计" width="500" />
最终算法的流程如下:
获取附近商家的步骤
用户请求:
- 用户搜索 500 米范围内的餐馆。
- 客户端将纬度(37.776720)、经度(-122.416730)和半径(500m)发送给负载均衡器。
转发请求:
- 负载均衡器(LB)把请求转发给位置服务(LBS)。
计算 Geohash:
- LBS 确定与半径匹配的 Geohash 长度。
- 根据参考表,500m 对应 Geohash 长度 6。
获取相邻 Geohash:
- LBS 计算相邻 Geohash,覆盖周边区域。
- 得到如下列表:
[my_geohash, neighbor1_geohash, neighbor2_geohash, ..., neighbor8_geohash]
从 Redis 获取商家 ID:
- LBS 针对列表中的每个 Geohash 查询 Geohash Redis 服务器,取得商家 ID。
- 并行查询以降低延迟。
获取商家信息并排序:
- LBS 从商家信息 Redis 服务器获取完整商家详情。
- 按商家与用户位置之间的距离排序。
- 把排序后的结果返回客户端。
关键优化
- 并行调用 Redis:缩短响应时间。
- Geohash 索引:高效执行空间查询。
- 缓存:加快商家数据的查找和读取。
这种方法可以低延迟、可扩展地检索用户附近的商家。
选择最佳索引方法
| 索引方法 | 优点 | 缺点 |
|---|---|---|
| Geohash | 易于实现,附近地点搜索效率高 | 存在边界问题,网格大小固定 |
| 四叉树 | 随密度动态调整,支持 k 近邻查询 | 更复杂,需要重新平衡树 |
| Google S2 | 地理围栏能力强,Google Maps 使用 | 实现难度较高 |