第 25 章:实时游戏排行榜
引言
我们要为一款在线手机游戏设计排行榜:
<img src="/images/chapter-25/leaderboard.png" alt="排行榜" width="500" />
第 1 步:理解问题并确定设计范围
- 候选人:排行榜分数如何计算?
- 面试官:玩家每赢一场比赛得 1 分。
- 候选人:所有玩家都在排行榜上吗?
- 面试官:是的。
- 候选人:排行榜有时间周期吗?
- 面试官:每个月开始一场新锦标赛,并建立新的排行榜。
- 候选人:可以假设只关心前 10 名吗?
- 面试官:需要显示前 10 名及指定用户的排名。如有时间,还可以讨论如何显示指定用户附近的玩家。
- 候选人:一场锦标赛有多少用户?
- 面试官:日活跃用户 500 万,月活跃用户 2500 万。
- 候选人:锦标赛期间,平均进行多少场比赛?
- 面试官:每位玩家平均每天进行 10 场。
- 候选人:两名玩家得分相同如何排名?
- 面试官:排名相同。如有时间,可讨论如何打破平局。
- 候选人:排行榜需要实时更新吗?
- 面试官:是的,应显示实时结果或尽可能接近实时的结果,不接受批量更新的历史结果。
功能需求
- 显示排行榜前 10 名玩家。
- 显示指定用户的排名。
- 显示指定用户前后各 4 名玩家(加分项)。
非功能需求
- 实时更新分数。
- 分数变化实时反映在排行榜上。
- 满足一般的可扩展性、可用性和可靠性要求。
粗略估算
原文这里以 5000 万日活跃用户为前提;若玩家在 24 小时内均匀分布,估算平均每秒有 50 位用户。不过实际分布通常不均,因此估计高峰时每秒有 250 位用户在线。
玩家得分的 QPS:假设每人每天平均玩 10 场,则 50 用户/秒 × 10 = 500 QPS,峰值 QPS 为 2500。
获取前 10 名的 QPS:假设用户平均每天打开一次排行榜,则为 50 QPS。
第 2 步:提出高层设计并取得共识
API 设计
第一个 API 用于更新用户分数:
POST /v1/scores它接收 user_id 和赢得一场比赛获得的 points 两个参数。只有游戏服务器可以调用,终端客户端不能直接访问。
下一个 API 用于获取排行榜前 10 名:
GET /v1/scores响应示例:
{
  "data": [
    {
      "user_id": "user_id1",
      "user_name": "alice",
      "rank": 1,
      "score": 12543
    },
    {
      "user_id": "user_id2",
      "user_name": "bob",
      "rank": 2,
      "score": 11500
    }
  ],
  ...
  "total": 10
}
也可以获取指定用户的分数:
GET /v1/scores/{:user_id}响应示例:
{
    "user_info": {
        "user_id": "user5",
        "score": 1000,
        "rank": 6,
    }
}
高层架构
<img src="/images/chapter-25/high-level-architecture.png" alt="高层架构" width="500" />
- 玩家赢得比赛后,客户端向游戏服务发出请求。
- 游戏服务验证胜利结果,然后调用排行榜服务更新玩家分数。
- 排行榜服务在排行榜存储中更新用户分数。
- 玩家调用排行榜服务,获取前 10 名和自己的排名等数据。
另一个考虑过的方案是让客户端直接向排行榜服务更新分数:
<img src="/images/chapter-25/alternative-design.png" alt="替代设计" width="500" />
该方案不安全,容易受到中间人攻击。玩家可以设置代理,随意篡改自己的分数。
如果游戏逻辑由服务器管理,客户端无须显式调用服务器记录胜利;服务器会根据游戏逻辑自动记录。
还可以考虑在游戏服务器和排行榜服务之间加入消息队列。如果其他服务也关心比赛结果,消息队列会有用;但面试题目前没有这一明确要求,因此本设计没有引入:
<img src="/images/chapter-25/message-queue-based-comm.png" alt="基于消息队列的通信" width="500" />
数据模型
下面讨论用于存储排行榜数据的关系型数据库、Redis 和 NoSQL 方案。NoSQL 方案留到深入设计部分。
关系型数据库方案
如果规模不大、用户不多,关系型数据库就能很好地满足需求。
可以从一张简单的排行榜表开始,每月建一张表(作者个人认为这不合理:可以添加 month 列,免去每月维护新表的麻烦):
<img src="/images/chapter-25/leaderboard-table.png" alt="排行榜表" width="500" />
表中还可以包含其他数据,但与后面的查询无关,故省略。
用户获得一分时会发生什么?
<img src="/images/chapter-25/user-wins-point.png" alt="用户得分" width="500" />
如果用户尚未出现在表中,先插入记录:
INSERT INTO leaderboard (user_id, score) VALUES ('mary1934', 1);后续调用只需更新分数:
UPDATE leaderboard set score=score + 1 where user_id='mary1934';如何找到排行榜的前几名?
<img src="/images/chapter-25/find-leaderboard-position.png" alt="查找排行榜名次" width="500" />
可以执行以下查询:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC;
但它需要扫描表并对全部记录排序,性能不佳。
可以给 score 建索引,并通过 LIMIT 避免扫描所有记录:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 10;
不过,如果用户不在榜首附近,还需要找出他的具体名次,该方法就难以扩展。
Redis 方案
我们希望在有数百万玩家时仍能高效运行,避免复杂的数据库查询。
Redis 是内存数据存储,速度很快;其有序集合正适合此需求。有序集合类似编程语言中的集合,但可以按指定条件保持排序。它内部使用哈希表维护键(user_id)和值(score)的映射,并用跳表按分数顺序关联用户:
<img src="/images/chapter-25/sorted-set.png" alt="有序集合" width="500" />
跳表如何工作?
它是支持快速查找的链表结构。
它由有序链表和多级索引构成。
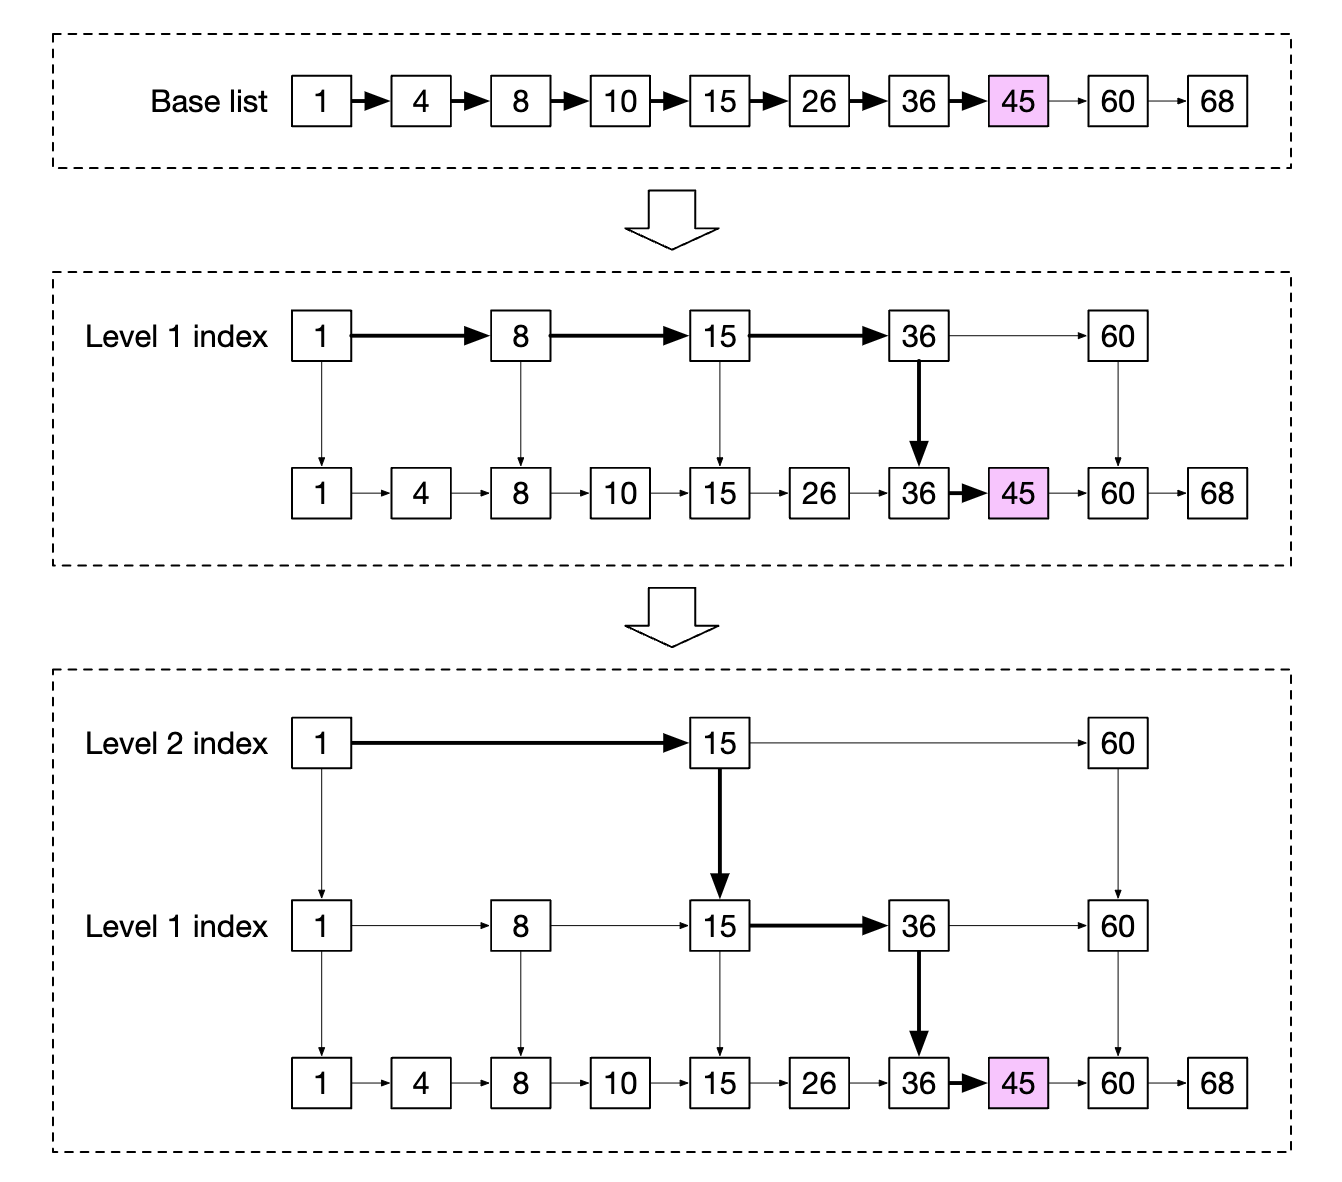
数据集较大时,跳表可快速查找指定值。下面的 64 节点示例中,普通链表需要经过 62 个节点才能找到目标值,而跳表只需经过 11 个节点:
<img src="/images/chapter-25/skip-list-performance.png" alt="跳表性能" width="500" />
有序集合始终保持排序,添加和查找的代价为 O(logN),因此比上述关系型数据库方案更适合此需求。
相比之下,关系型数据库需要运行下面的嵌套查询才能找出指定用户的名次:
SELECT *,(SELECT COUNT(*) FROM leaderboard lb2
WHERE lb2.score >= lb1.score) RANK
FROM leaderboard lb1
WHERE lb1.user_id = {:user_id};
操作 Redis 排行榜需要哪些命令?
- ZADD:用户不存在时将其插入集合,否则更新分数。时间复杂度 O(logN)。
- ZINCRBY:按指定数值增加用户分数。用户不存在时从零开始。时间复杂度 O(logN)。
- ZRANGE/ZREVRANGE:按分数获取一段用户,可指定排序方向(ASC/DESC)、偏移和结果数量。时间复杂度 O(logN+M),其中 M 是结果数量。
- ZRANK/ZREVRANK:按升序或降序获取指定用户的位置(排名)。时间复杂度 O(logN)。
用户得到一分时:
ZINCRBY leaderboard_feb_2021 1 'mary1934'每个月建立新排行榜,旧排行榜迁移到历史存储。
用户获取前 10 名时:
ZREVRANGE leaderboard_feb_2021 0 9 WITHSCORES结果示例:
[(user2,score2),(user1,score1),(user5,score5)...]用户要查看自己附近的排名时:
<img src="/images/chapter-25/leaderboard-position-of-user.png" alt="用户在排行榜上的位置" width="500" />
已知用户排名后,可以执行:
ZREVRANGE leaderboard_feb_2021 357 365用户排名可通过 ZREVRANK <user-id> 获取。
再估算存储需求:
- 最坏情况下,2500 万月活跃用户都参与了当月游戏。
- 若 ID 是 24 字符字符串,分数是 16 位整数,则需要 26 字节 × 2500 万 ≈ 650 MB。
- 即使考虑跳表开销后将容量加倍,这些数据仍容易放入现代 Redis 集群。
另一项非功能需求是支持每秒 2500 次更新,这完全在单台 Redis 服务器的能力范围内。
其他注意事项:
- 可以启动 Redis 副本,避免 Redis 服务器宕机时丢失数据。
- 也可以使用 Redis 持久化,在故障后恢复数据。
- 需要在 MySQL 中使用两张辅助表:一张保存用户名、显示名称等用户资料,另一张记录用户获胜等事件。
- 基础设施故障时,可用第二张表重建排行榜。
- 前 10 名玩家的资料访问频繁,可缓存以略微提高性能。
第 3 步:深入设计
是否使用云服务商
可以自行部署和管理服务,也可以让云服务商代管。
如果自行管理,则用 Redis 保存排行榜,用 MySQL 保存用户资料;若需要扩展数据库,还可以缓存用户资料:
<img src="/images/chapter-25/manage-services-ourselves.png" alt="自行管理服务" width="500" />
另一种做法是使用云产品管理许多服务。例如用 AWS API Gateway 将 API 调用路由到 AWS Lambda 函数:
<img src="/images/chapter-25/api-gateway-mapping.png" alt="API 网关映射" width="500" />
AWS Lambda 让我们无须自行配置和管理服务器就能运行代码。它按需运行,并自动扩展。
用户得分示例:
<img src="/images/chapter-25/user-scoring-point-lambda.png" alt="通过 Lambda 记录用户得分" width="500" />
用户获取排行榜示例:
<img src="/images/chapter-25/user-retrieve-leaderboard.png" alt="用户获取排行榜" width="500" />
Lambda 是无服务器架构的一种实现,让我们无须管理扩容和运行环境。作者建议从头构建游戏时采用这一方案。
扩展 Redis
日活跃用户 500 万时,从存储和 QPS 两方面看,单个 Redis 实例就够了。
若设想用户群扩大 10 倍至 5 亿日活跃用户,则需要 65 GB 存储,QPS 将达到 25 万。这样的规模需要分片。
一种方法是按范围划分数据:
<img src="/images/chapter-25/range-partition.png" alt="范围分区" width="500" />
这里根据用户分数分片,在应用代码中维护 user_id 到分片的映射。映射本身可存于 MySQL 或另一个缓存。
获取前 10 名时,查询分数最高的分片([900-1000])。
获取用户排名时,先算出他在所属分片中的排名,再加上其他高分分片的用户总数。后一步可通过 info keyspace 命令快速取得各分片记录数,因此是 O(1) 操作。
另一种方法是通过 Redis Cluster 做哈希分区。它按与一致性哈希相似但并不完全相同的方式,将数据分布在 Redis 节点上:
<img src="/images/chapter-25/hash-partition.png" alt="哈希分区" width="500" />
这时计算前 10 名较困难,需要从每个分片取出前 10 名,再在应用中合并:
<img src="/images/chapter-25/top-10-players-calculation.png" alt="计算前 10 名玩家" width="500" />
哈希分区有以下局限:
- 如果需要获取前 K 名且 K 较大,就要从所有分片读取大量数据,延迟可能升高。
- 分区数量增加也会增加延迟。
- 没有直接的方法确定用户的全局排名。
基于这些原因,作者倾向于在该问题中使用固定范围分区。
其他注意事项:
- 对写入密集的 Redis 节点,最佳实践之一是分配所需内存的两倍,以便在需要时生成快照。
- 可使用 Redis-benchmark 测试 Redis 部署的性能,再据此做决定。
替代方案:NoSQL
还可考虑使用适合以下需求的 NoSQL 数据库:
- 大量写入。
- 按分数高效排序同一分区中的数据。
DynamoDB、Cassandra 或 MongoDB 都是合适的候选方案。
本章作者选择 DynamoDB。它是完全托管的 NoSQL 数据库,提供稳定性能与良好扩展能力。需要查询非主键字段时,也能使用全局二级索引。
<img src="/images/chapter-25/dynamo-db.png" alt="DynamoDB" width="500" />
先创建一张存储国际象棋游戏排行榜的表:
<img src="/images/chapter-25/chess-game-leaderboard-table-1.png" alt="国际象棋排行榜表 1" width="500" />
这种设计基本可行,但按分数查询时不易扩展,因此可以把分数设为排序键:
<img src="/images/chapter-25/chess-game-leaderboard-table-2.png" alt="国际象棋排行榜表 2" width="500" />
另一个问题是按月份分区:最新月份的访问量远高于其他月份,会形成热点分区。
可以使用写入分片技术,根据 user_id % num_partitions 计算分区编号,再把编号附加到各个键上:
<img src="/images/chapter-25/chess-game-leaderboard-table-3.png" alt="国际象棋排行榜表 3" width="500" />
分区数量需要权衡:
- 分区越多,写入的扩展能力越强。
- 但读取时必须查询更多分区并汇总结果,读取的扩展能力会受到影响。
这种方法需要使用前面见过的“分散查询、集中汇总”(scatter-gather)。分区越多,所需时间越长:
<img src="/images/chapter-25/scatter-gather-2.png" alt="分散查询与集中汇总" width="500" />
要合理确定分区数量,需要进行基准测试。
这种 NoSQL 方案仍有一个主要缺点:很难计算指定用户的精确名次。
如果规模已大到必须分片,也许可以改为告诉用户其分数处于哪个百分位。
可通过定时任务定期分析分数分布,并据此确定用户所在的百分位,例如:
第 10 百分位 = 分数 < 100
第 20 百分位 = 分数 < 500
...
第 90 百分位 = 分数 < 6500
第 4 步:总结
如有时间,还可以讨论:
- 更快获取数据: 用 Redis 哈希缓存用户对象,建立
user_id -> user object映射,比查询数据库更快。 - 打破平局: 两名玩家同分时,可按最近一次参赛时间排序。
- 系统故障恢复: 大规模 Redis 故障后,可遍历 MySQL 的 WAL 记录,使用临时脚本重建排行榜。