第 21 章:广告点击事件聚合
引言
随着 Facebook、YouTube、TikTok 等平台的发展,数字广告已成为规模庞大的行业。
因此,追踪广告点击事件很重要。本章探索如何设计一个达到 Facebook 或 Google 规模的广告点击事件聚合系统。
数字广告中有一种称为**实时竞价(RTB)**的流程,用于买卖数字广告库存:
<img src="/images/chapter-21/digital-advertising-example.png" alt="数字广告示例" width="500" />
RTB 通常在一秒内完成,因此速度很重要。数据准确性同样重要,因为它会影响广告主支付的金额。
广告主可以根据点击事件聚合结果,调整目标受众和关键词等策略。
第 1 步:理解问题并确定设计范围
- 候选人:输入数据是什么格式?
- 面试官:每天有 10 亿次广告点击,共 200 万条广告。点击事件数每年增长 30%。
- 候选人:系统主要要支持哪些查询?
- 面试官:重点考虑以下查询:
- 返回广告 X 在过去 Y 分钟内的点击次数。
- 返回过去 1 分钟点击量最高的 100 条广告。两个参数都应可配置;每分钟聚合一次。
- 上述查询支持按
ip、user_id、country过滤。
- 候选人:需要考虑哪些边界情况?我想到:
- 事件可能晚于预期到达。
- 事件可能重复。
- 系统的不同部分可能停机,因此需要考虑恢复。
- 面试官:这些都要考虑。
- 候选人:延迟要求是什么?
- 面试官:广告点击聚合的端到端延迟最多几分钟;RTB 要求不到一秒。点击聚合主要用于计费和报表,因此几分钟延迟可以接受。
功能需求
- 聚合
ad_id在过去 Y 分钟的点击数。 - 每分钟返回点击量最高的 100 个
ad_id。 - 支持根据不同属性过滤聚合结果。
- 数据集规模与 Facebook 或 Google 相当。
非功能需求
- 聚合结果用于 RTB 和广告计费,正确性很重要。
- 妥善处理延迟到达或重复的事件。
- 系统应有韧性,能够承受局部故障。
- 端到端延迟最多几分钟。
粗略估算
- 10 亿日活跃用户。
- 假设每位用户每天点击一条广告,则每天有 10 亿次点击。
- 广告点击平均 QPS 为 10,000。
- 峰值 QPS 为平均值的 5 倍,即 50,000。
- 单次广告点击占用 0.1 KB,每日所需存储约 100 GB。
- 每月所需存储约 3 TB。
第 2 步:提出概要设计并达成共识
本节讨论查询 API、数据模型和概要设计。
查询 API 设计
API 是客户端与服务器之间的契约。这里的客户端是仪表盘用户,例如数据科学家、分析师或广告主。
功能需求包括:
- 聚合
ad_id在过去 Y 分钟的点击数。 - 返回过去 M 分钟点击量最高的 N 个
ad_id。 - 支持根据不同属性过滤聚合结果。
需要两个接口;过滤条件可通过查询参数传入。
聚合某个 ad_id 在过去 M 分钟的点击数:
GET /v1/ads/{:ad_id}/aggregated_count查询参数:
from:起始分钟,默认当前时间前 1 分钟。to:结束分钟,默认当前时间。filter:过滤策略标识,例如001表示“非美国的点击”。
响应:
ad_id:广告标识。count:起止分钟之间的聚合点击数。
返回过去 M 分钟点击量最高的 N 个广告 ID:
GET /v1/ads/popular_ads查询参数:
count:返回点击量最高的 N 条广告。window:聚合窗口大小,单位为分钟。filter:过滤策略标识。
响应:
- 广告 ID 列表。
数据模型
系统保存原始数据和聚合数据。
原始数据如下:
[AdClickEvent] ad001, 2021-01-01 00:00:01, user 1, 207.148.22.22, USA结构化示例:
| ad_id | click_timestamp | user | ip | country |
|---|---|---|---|---|
| ad001 | 2021-01-01 00:00:01 | user1 | 207.148.22.22 | USA |
| ad001 | 2021-01-01 00:00:02 | user1 | 207.148.22.22 | USA |
| ad002 | 2021-01-01 00:00:02 | user2 | 209.153.56.11 | USA |
聚合后的数据:
| ad_id | click_minute | filter_id | count |
|---|---|---|---|
| ad001 | 202101010000 | 0012 | 2 |
| ad001 | 202101010000 | 0023 | 3 |
| ad001 | 202101010001 | 0012 | 1 |
| ad001 | 202101010001 | 0023 | 6 |
filter_id 用于支持过滤需求。
| filter_id | region | IP | user_id |
|---|---|---|---|
| 0012 | US | * | * |
| 0013 | * | 123.1.2.3 | * |
为快速返回过去 M 分钟点击量最高的 N 条广告,还要维护以下结构:
| most_clicked_ads | ||
|---|---|---|
| window_size | integer | 聚合窗口大小(M 分钟) |
| update_time_minute | timestamp | 最近更新时间戳(精度为 1 分钟) |
| most_clicked_ads | array | JSON 格式的广告 ID 列表 |
保存原始数据和聚合数据各有什么优缺点?
- 原始数据保留完整信息,支持过滤和重新计算。
- 聚合数据的数据集更小、查询更快。
- 原始数据占用更多存储,查询也更慢。
- 聚合数据是派生数据,因此会损失部分原始信息。
本设计结合两种方式:
- 保留原始数据便于调试。若聚合逻辑存在错误,可以定位问题并回填。
- 同时存储聚合数据,以提升查询性能。
- 原始数据可放入冷存储,降低成本。
选择数据库时,要考虑:
- 数据是关系型、文档型还是二进制对象?
- 负载以读取、写入还是两者为主?
- 是否需要事务?
- 查询是否依赖
SUM、COUNT等 OLAP 函数?
原始数据平均 10,000 QPS、峰值 50,000 QPS,因此写入密集。原始数据主要在出问题时作为备份使用,读取量较低。
关系型数据库可以完成任务,但扩展写入能力可能困难。Cassandra 或 InfluxDB 对高写入负载有更好的原生支持。
另一选择是 Amazon S3 搭配 ORC、Parquet 或 AVRO 等列式数据格式。由于这种组合不够熟悉,这里选择 Cassandra。
聚合数据同时承受大量读写:仪表盘和告警持续查询,聚合服务也每分钟写入一次。因此,这里同样采用 Cassandra。
概要设计
系统如下:
<img src="/images/chapter-21/high-level-design-1.png" alt="概要设计一" width="500" />
输入与输出都作为无边界的数据流传输。
为了避免同步下游节点在消费者崩溃时阻塞整个系统,使用消息队列(Kafka)进行异步处理,让生产者与消费者解耦。
<img src="/images/chapter-21/high-level-design-2.png" alt="概要设计二" width="500" />
第一个消息队列存储广告点击事件:
| ad_id | click_timestamp | user_id | ip | country |
|---|
第二个消息队列存储每分钟聚合的广告点击数:
| ad_id | click_minute | count |
|---|
以及每分钟聚合的点击量最高的 N 条广告:
| update_time_minute | most_clicked_ads |
|---|
设置第二个消息队列,是为了实现端到端的“恰好一次”原子提交语义:
<img src="/images/chapter-21/atomic-commit.png" alt="原子提交" width="500" />
对于聚合服务,MapReduce 框架是一个可选方案:
<img src="/images/chapter-21/ad-count-map-reduce.png" alt="广告点击计数的 MapReduce" width="500" />

<img src="/images/chapter-21/top-100-map-reduce.png" alt="前 100 条广告的 MapReduce" width="500" />
每个节点负责单一任务,并把处理结果发送给下游节点。
Map 节点从数据源读取数据,再进行过滤和转换。
例如,Map 节点可按 ad_id 将数据分配给不同聚合节点:
<img src="/images/chapter-21/map-node.png" alt="Map 节点" width="500" />
另一种方式是将广告分布到 Kafka 分区,让聚合节点作为消费者组成员直接订阅。但独立的 Map 节点可在后续处理前清洗或转换数据。
此外,如果我们无法控制数据的生产方式,同一 ad_id 的事件可能被送入不同分区,也需要 Map 节点重新分配。
聚合节点每分钟在内存中按 ad_id 统计点击事件。
Reduce 节点汇总聚合节点的结果,生成最终结果:
<img src="/images/chapter-21/reduce-node.png" alt="Reduce 节点" width="500" />
这个有向无环图(DAG)采用 MapReduce 范式,利用分布式并行计算,将海量数据转换为较小的聚合结果。
在 DAG 中,中间数据存放在内存;不同节点通过 TCP 或共享内存通信。
下面看它如何满足各种使用场景。
场景 1:聚合点击次数:
<img src="/images/chapter-21/use-case-1.png" alt="场景一" width="500" />
- 使用
ad_id % 3对广告分区。
场景 2:返回点击量最高的 N 条广告:
<img src="/images/chapter-21/use-case-2.png" alt="场景二" width="500" />
- 示例聚合前 3 条广告,也可轻松扩展到前 N 条。
- 每个节点维护堆,以便快速取得前 N 条广告。
场景 3:数据过滤: 为快速过滤,可预定义过滤条件,并按条件预先聚合:
| ad_id | click_minute | country | count |
|---|---|---|---|
| ad001 | 202101010001 | USA | 100 |
| ad001 | 202101010001 | GPB | 200 |
| ad001 | 202101010001 | others | 3000 |
| ad002 | 202101010001 | USA | 10 |
| ad002 | 202101010001 | GPB | 25 |
| ad002 | 202101010001 | others | 12 |
这种技术称为星型模式,广泛应用于数据仓库。过滤字段称为维度。
优点:
- 易于理解和实现。
- 现有聚合服务可复用,逐步增加星型模式的维度。
- 结果已预先计算,按条件访问速度快。
局限是会产生更多分组和记录;过滤条件越多,增长越明显。
第 3 步:深入设计
下面进一步讨论几个重要主题。
流处理与批处理
前述概要架构属于流处理系统。三类系统对比如下:
| 服务(在线系统) | 批处理系统(离线系统) | 流处理系统(近实时系统) | |
|---|---|---|---|
| 响应能力 | 快速响应客户端 | 无需响应客户端 | 无需响应客户端 |
| 输入 | 用户请求 | 有边界、有限但量大的数据 | 无边界输入(无限数据流) |
| 输出 | 给客户端的响应 | 物化视图、聚合指标等 | 物化视图、聚合指标等 |
| 性能衡量 | 可用性、延迟 | 吞吐量 | 吞吐量、延迟 |
| 示例 | 在线购物 | MapReduce | Flink [13] |
本设计结合了流处理与批处理。
新数据到达时,通过流处理近实时生成聚合结果;历史数据备份则使用批处理。
同时存在批处理与流处理两条处理路径的架构称为 Lambda 架构。缺点是需要维护两套处理代码。
Kappa 架构将批处理与流处理合并为一条路径,核心是使用同一个流处理引擎。
Lambda 架构:
<img src="/images/chapter-21/lambda-architecture.png" alt="Lambda 架构" width="500" />
Kappa 架构:
<img src="/images/chapter-21/kappa-architecture.png" alt="Kappa 架构" width="500" />
本章概要设计采用 Kappa 架构,因为历史数据的重新处理也经过聚合服务。
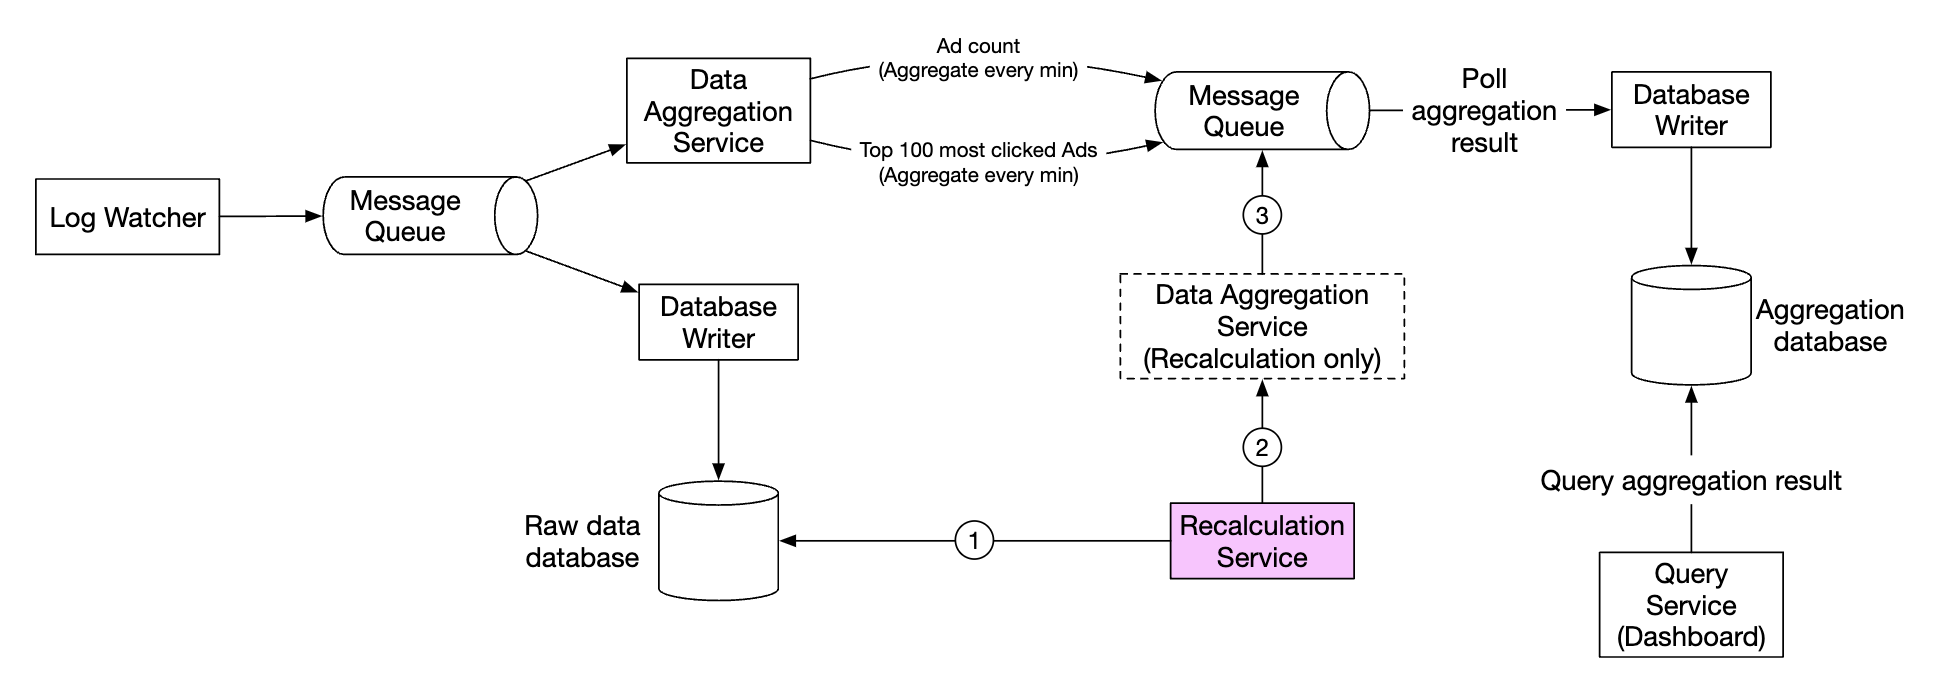
例如,当聚合逻辑出现严重错误,必须重新计算聚合数据时,可以从保存的原始数据重新计算:
重算服务从原始数据存储读取数据,这一步是批处理任务。
将读取的数据发送到专用聚合服务,避免影响实时聚合服务。
聚合结果进入第二个消息队列,再更新聚合数据库中的结果。
时间
聚合需要时间戳,可在两个时点生成:
- 事件时间:广告点击发生时。
- 处理时间:服务器处理事件时的系统时间。
异步消息队列和网络延迟可能使两者差异很大:
- 使用处理时间,聚合结果可能不准确。
- 使用事件时间,就必须处理延迟到达的事件。
没有完美方案,需要权衡:
| 优点 | 缺点 | |
|---|---|---|
| 事件时间 | 聚合结果更准确 | 客户端时钟可能有误,也可能被恶意用户伪造 |
| 处理时间 | 服务器时间戳更可靠 | 事件迟到时,时间戳不对应实际点击时间 |
由于数据准确性很重要,这里按事件时间聚合。
为缓解延迟事件带来的问题,可以使用“水位线”(watermark)技术。
下例中,事件 2 错过了本应进入的聚合窗口:
<img src="/images/chapter-21/watermark-technique.png" alt="水位线技术" width="500" />
如果有意延长聚合窗口,就能降低遗漏事件的概率。窗口延长部分由水位线控制:
<img src="/images/chapter-21/watermark-2.png" alt="水位线示例" width="500" />
- 水位线允许的等待时间短,延迟低,但更可能漏掉事件。
- 等待时间长,漏掉事件的概率较低,但延迟更高。
无论如何设置水位线,都可能漏掉极少数事件。与其为这些低概率事件无限延长等待时间,不如在每日结束时进行对账,修正不一致。
聚合窗口
窗口函数有四种:
- 滚动窗口(固定窗口)。
- 跳跃窗口。
- 滑动窗口。
- 会话窗口。
广告点击计数使用滚动窗口:
<img src="/images/chapter-21/tumbling-window.png" alt="滚动窗口" width="500" />
过去 M 分钟点击量最高的 N 条广告使用滑动窗口:
<img src="/images/chapter-21/sliding-window.png" alt="滑动窗口" width="500" />
投递保证
聚合数据用于计费,因此准确性优先。
需要讨论:
- 如何避免处理重复事件。
- 如何确保所有事件都得到处理。
可用的投递保证有至多一次、至少一次和恰好一次。
多数场景下,若能接受少量重复,“至少一次”就足够。但本系统中,即使只有几个百分点的差异,也可能造成数百万美元的偏差,因此需要“恰好一次”投递语义。
数据去重
重复数据是最常见的数据质量问题之一。
来源很多:
- 客户端:可能多次发送同一事件。恶意重复事件最好由风控引擎处理。
- 服务器故障:聚合服务节点在处理中停机,上游没有收到确认,于是重新发送事件。
下面是最后一跳没有确认事件而产生重复的例子:
<img src="/images/chapter-21/data-duplication-example.png" alt="数据重复示例" width="500" />
此处偏移量 100 会被处理并发送给下游多次。
一种缓解办法是将最近处理的偏移量保存到 HDFS 或 S3,但这样可能出现结果从未到达下游、偏移量却已保存的情况:
<img src="/images/chapter-21/data-duplication-example-2.png" alt="数据重复示例二" width="500" />
最终,可以将保存偏移量与向下游写入作为一个原子操作;这需要分布式事务:
<img src="/images/chapter-21/data-duplication-example-3.png" alt="数据重复示例三" width="500" />
个人补充: 如果下游以幂等方式处理聚合结果,也可以不使用分布式事务。
扩展系统
下面讨论系统增长时如何扩展。
消息队列、聚合服务和数据库是三个独立组件。由于它们彼此解耦,可以分别扩展。
消息队列如何扩展:
不限制生产者数量,因此生产者容易扩展。
将消费者组织为消费者组,并增加消费者数量。
为此还要提前创建足够多的分区。
当消费者达到数千个时,再均衡可能耗时较长,建议在非高峰时段操作。
也可按地域划分主题,例如
topic_na、topic_eu。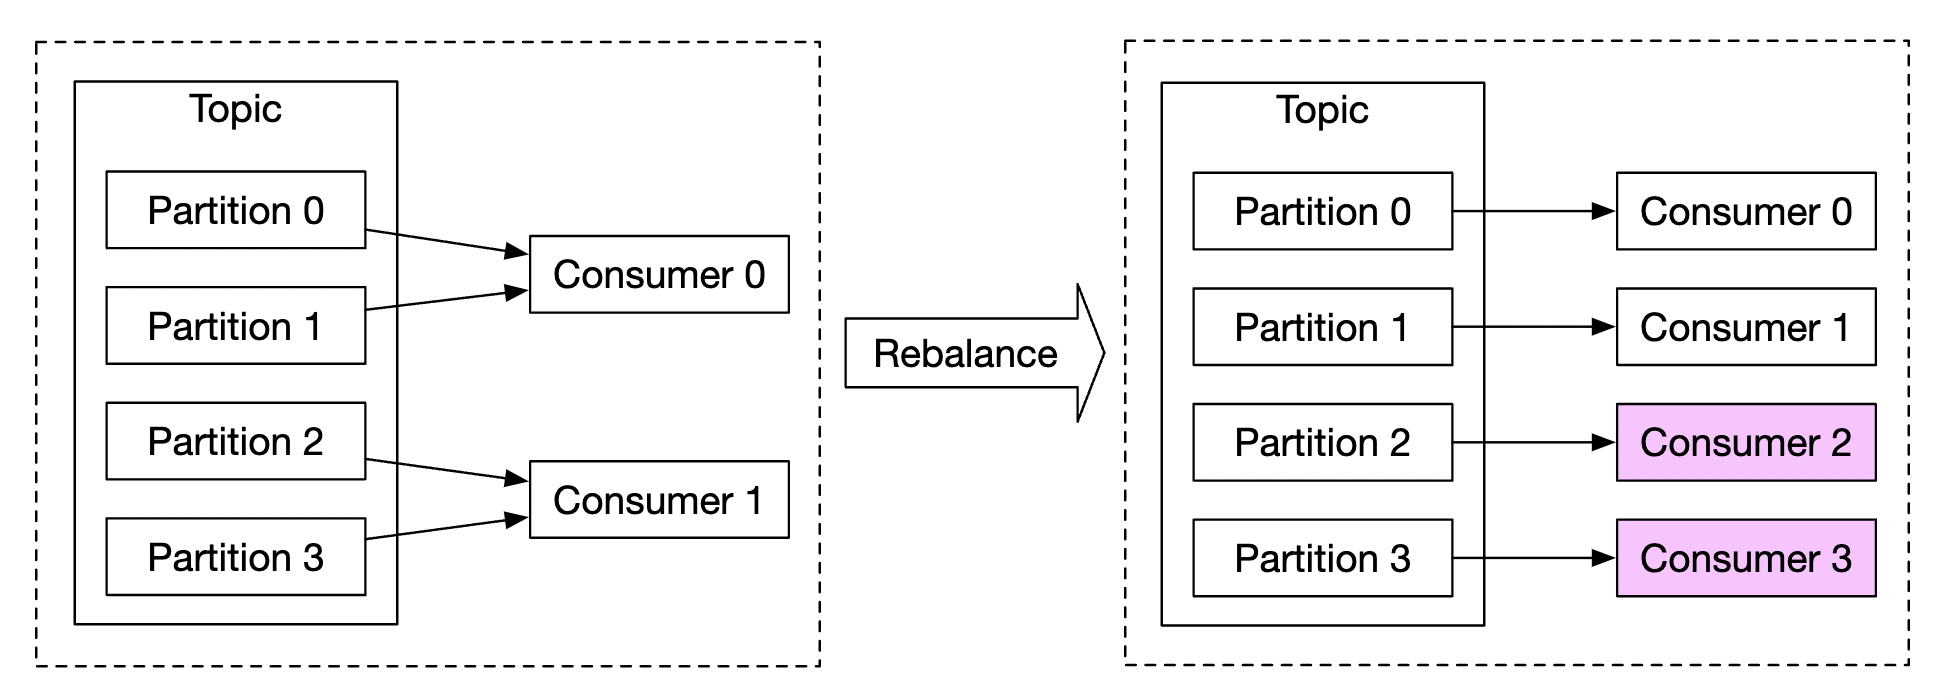
聚合服务如何扩展:
<img src="/images/chapter-21/aggregation-service-scaling.png" alt="聚合服务扩展" width="500" />
增加 MapReduce 节点即可横向扩展。
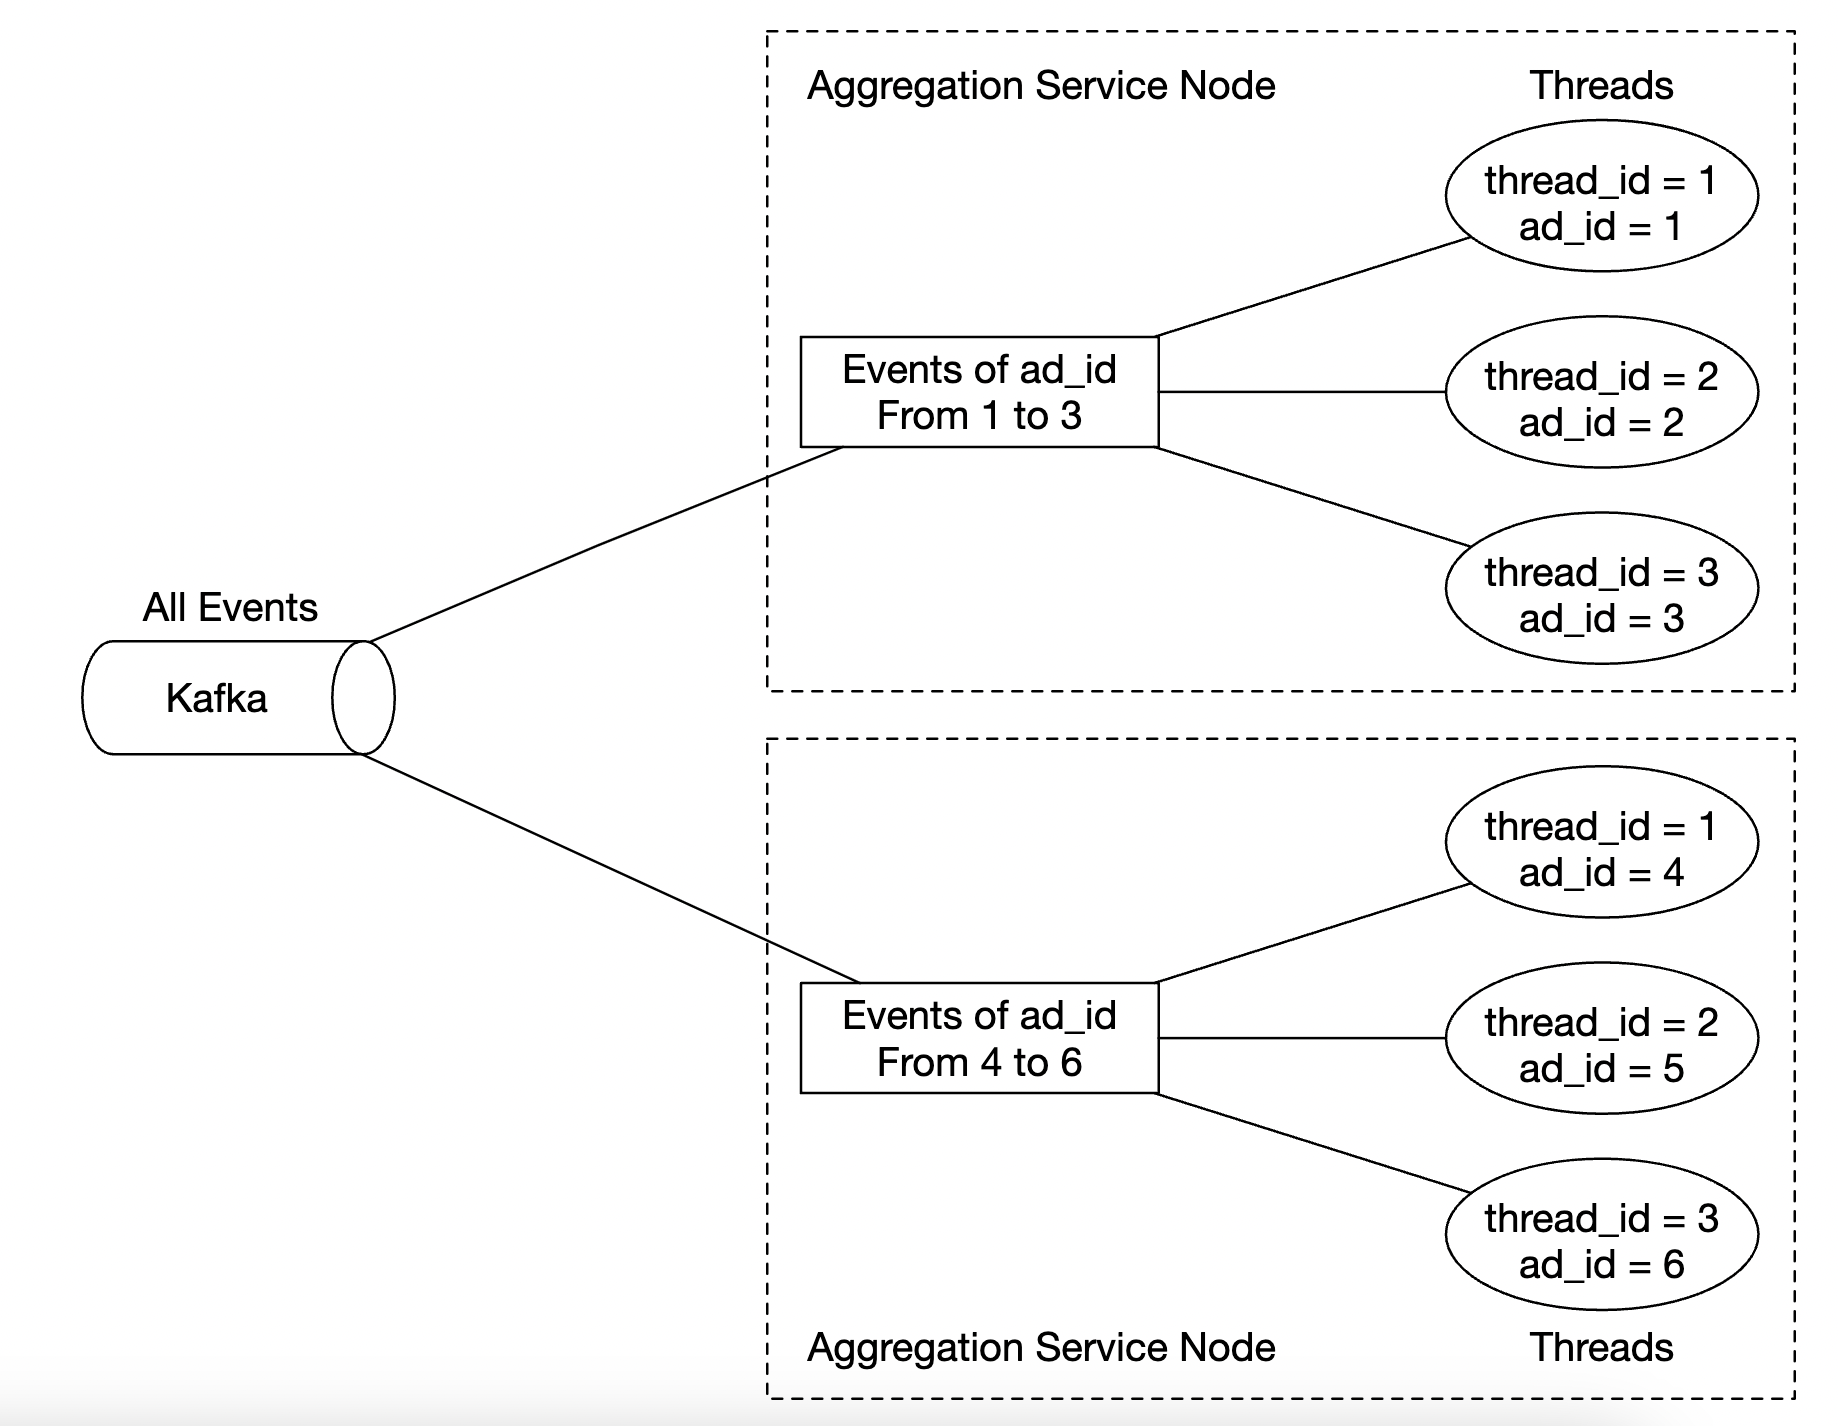
利用多线程可以提高聚合服务吞吐量。
也可以借助 Apache YARN 等资源管理平台进行多进程处理。
多线程较简单,但多进程方案更易扩展,因此实践中更常见。
多线程示例如下:
数据库如何扩展:
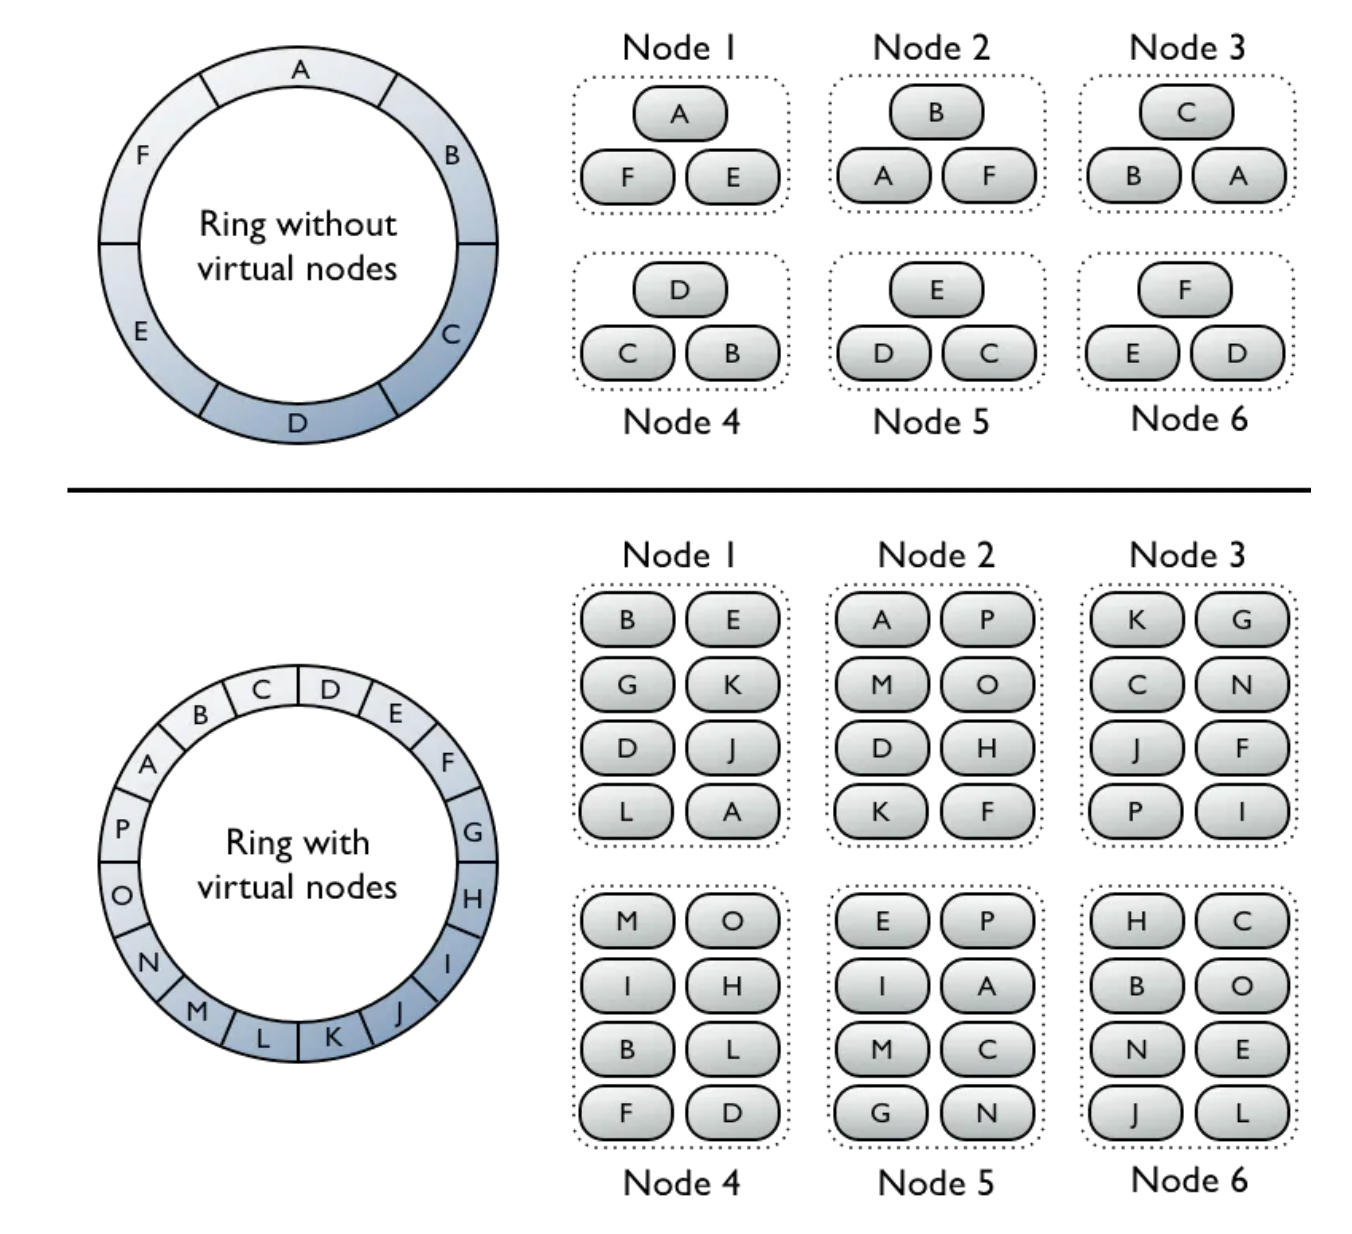
Cassandra 原生支持基于一致性哈希的横向扩展。
向集群添加节点时,数据会在各个虚拟节点之间自动再均衡。
无需手动重新分片。
还要考虑热点:某条广告的热度远高于其他广告时怎么办?
<img src="/images/chapter-21/hotspot-issue.png" alt="热点问题" width="500" />
- 图中聚合服务节点向资源管理器申请额外资源。
- 资源管理器分配资源,避免原节点过载。
- 原节点将事件拆成三组,每个聚合节点处理 100 个事件。
- 各节点把结果写回原聚合节点。
更复杂的热点处理方式还包括:
- 全局/局部聚合。
- 拆分去重聚合。
容错
聚合节点在内存中处理数据。如果节点停机,已处理但尚未持久化的数据会丢失。
其他节点接管后,可以利用 Kafka 消费者偏移量从上次位置继续。不过,计算过去 M 分钟内点击量最高的 N 条广告,还需要保存额外的中间状态。
可在某个分钟边界为进行中的聚合制作快照:
<img src="/images/chapter-21/fault-tolerance-example.png" alt="容错示例" width="500" />
节点停机后,新节点读取最近提交的消费者偏移量及最新快照,然后继续任务:
<img src="/images/chapter-21/fault-tolerance-recovery-example.png" alt="容错恢复示例" width="500" />
数据监控与正确性
聚合数据用于计费,必须严格监控,保证结果正确。
可以监测:
- 延迟:跟踪不同事件的时间戳,了解系统的端到端延迟。
- 消息队列积压:积压突然增加时,应增加聚合节点。Kafka 基于分布式提交日志,因此应监控记录滞后量(records lag)。
- 聚合节点资源:CPU、磁盘、JVM 等。
还需要每日结束时运行批量对账任务。它从原始数据重新计算聚合结果,并与聚合数据库中的实际数据比较:
<img src="/images/chapter-21/reconciliation-flow.png" alt="对账流程" width="500" />
替代设计
在通用系统设计面试中,不要求掌握大数据处理软件的内部细节。
解释设计思路并讨论权衡,比记住具体工具更重要,因此本章介绍了通用方案。
另一种使用现成工具的设计是:将广告点击数据存入 Hive,并在其上方建立 Elasticsearch 查询层,加快查询。
聚合通常可由 ClickHouse 或 Druid 等 OLAP 数据库完成。
<img src="/images/chapter-21/alternative-design.png" alt="替代设计" width="500" />
第 4 步:总结
本章讨论了:
- 数据模型与 API 设计。
- 使用 MapReduce 聚合广告点击事件。
- 扩展消息队列、聚合服务和数据库。
- 缓解热点问题。
- 持续监控系统。
- 使用对账保证正确性。
- 容错。
广告点击事件聚合是典型的大数据处理系统。
如果事先了解以下相关技术,会更容易理解和设计它:
- Apache Kafka。
- Apache Spark。
- Apache Flink。