第 7 章:设计分布式系统中的唯一 ID 生成器
引言
本章讨论如何为分布式系统设计唯一 ID 生成器。传统自增主键在分布式环境中面临扩展和同步问题,因此不适合直接使用。目标是生成符合以下要求的唯一、可排序的 64 位数字 ID:
- ID 必须唯一,并且按时间有序。
- ID 必须能放入 64 位。
- 系统每秒应生成超过 10,000 个 ID。
第 1 步:理解问题
基本要求
- ID 必须是唯一的数字,且能放入 64 位。
- ID 随时间递增,但不要求严格每次
+1。 - ID 应能按时间排序。
- 系统必须支持高吞吐量(每秒 10,000 个 ID)。
第 2 步:高层设计选项
1. 多主复制
方法: 使用数据库的
auto_increment,并按步长递增(例如有 k 台服务器时每次+k)。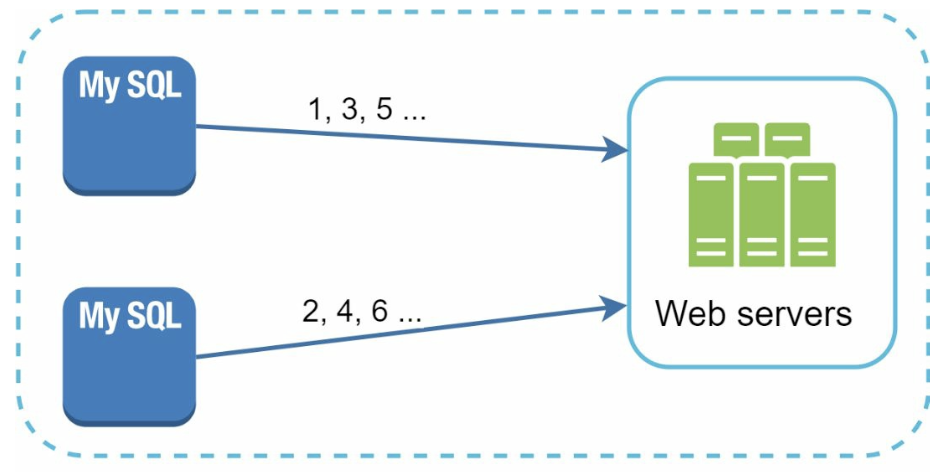
缺点:
- 难以跨数据中心扩展。
- ID 不一定随时间递增。
- 增加或移除服务器时,扩展比较麻烦。
2. UUID(通用唯一标识符)
方法:
各服务器独立生成 128 位的 UUID。
服务器之间无需协调即可生成 UUID。
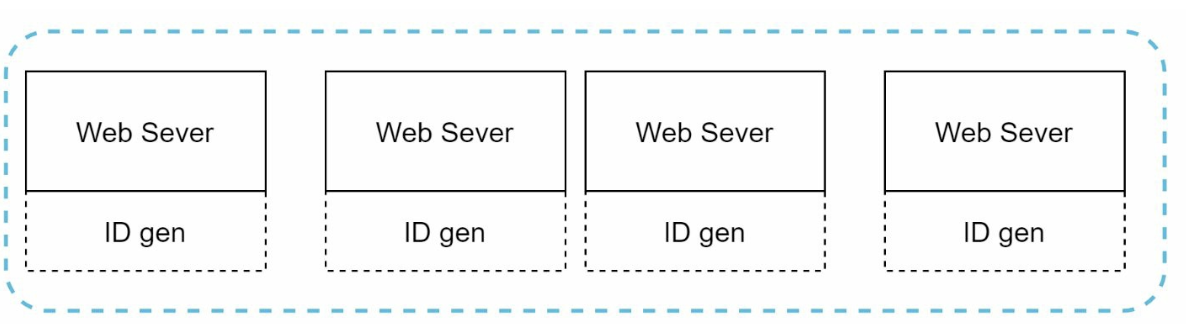
优点:
- 服务器之间无需协调。
- 可以随 Web 服务器轻松扩展。
缺点:
- 超出 64 位要求。
- ID 无法按时间排序,也可能不是数字形式。
3. 发号服务器
方法: 使用集中式数据库服务器递增并分配 ID。
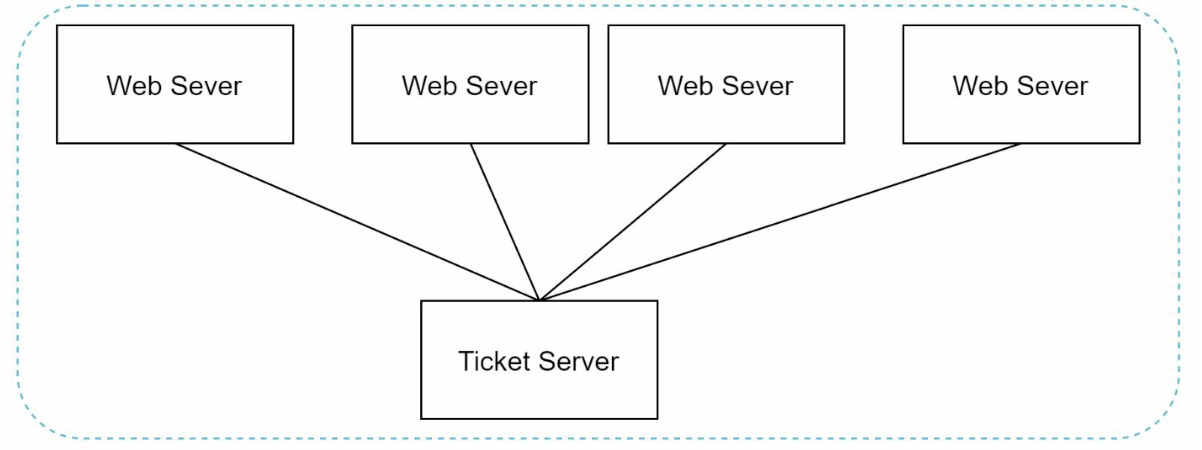
优点:
- 小规模系统中容易实现。
- 生成数字 ID。
缺点:
- 存在单点故障。
- 多服务器部署时会遇到同步挑战。
4. Twitter Snowflake 方案
方法:
<img src="/images/chapter-07/twitter-snowflake.png" alt="Snowflake 方案" width="500" /> <img src="/images/chapter-07/snowflake-id-breakdown.png" alt="Snowflake ID 结构" width="500" />- 将 ID 划分为多个字段,以保证唯一性和可扩展性。
- 符号位(1 位): 始终为
0,可用于区分有符号数和无符号数。 - 时间戳(41 位): 自定义纪元以来的毫秒数(Twitter 默认纪元为
1288834974657,即 UTC 时间 2010 年 11 月 04 日 01:42:54),使 ID 按时间有序。 - 数据中心 ID(5 位): 最多标识
2^5 = 32个数据中心。 - 机器 ID(5 位): 每个数据中心最多标识
2^5 = 32台机器。 - 序列号(12 位): 标记同一台机器在同一毫秒内生成的 ID,最多支持每毫秒
2^12 = 4096个 ID。序列号每毫秒重置为0。
优点:
- 可扩展性: 多服务器可处理每秒超过 10,000 个 ID。
- 时间顺序: ID 可以按时间排序。
- 去中心化: 没有单点故障。
第 4 步:其他注意事项
1. 时钟同步
- 挑战: ID 生成依赖服务器时钟同步。
- 解决方案: 使用**网络时间协议(NTP)**尽量减小时间偏差。
2. 字段长度调整
- 根据场景调整各字段的位数,例如减少序列号位数、增加时间戳位数。
3. 高可用性
- ID 生成器属于关键基础设施,必须具备容错能力。
- 应考虑冗余与故障切换机制。