第 13 章:设计搜索自动补全系统
简介
自动补全也称输入提示或渐进式搜索,会在用户向搜索框输入文字时实时给出建议。系统需根据历史查询数据,高效返回相关且热门的前 k 条建议。
主要功能
- 最多提供 5 条自动补全结果。
- 根据查询热度(频率)排序。
- 仅支持小写英文字母。
- 响应迅速(小于 100 ms),且可扩展。
第一步:理解问题
需求
- **实时建议:**用户输入时显示相关匹配项。
- **Top-k 结果:**按热度排序,最多返回 5 条。
- **可扩展性:**支持 1000 万 DAU,峰值为 48,000 QPS。
- **高可用性:**发生故障时仍保持服务可用。
- **数据增长:**每天新增查询数据约 0.4 GB。
第二步:概要设计
系统分为两个服务:
- 数据收集服务:
- 收集用户查询并聚合频率数据。
- 对大型数据集进行实时处理并不实际,但可以作为初始设计。
- **查询服务:**根据用户输入返回前 k 条建议。
数据收集服务
<img src="/images/chapter-13/data-gathering.png" alt="数据收集" width="600" />
- 聚合分析日志中的查询数据,更新频率表。
- 每周处理历史数据,构建字典树(trie)。
查询服务
<img src="/images/chapter-13/frequency-table.png" alt="频率表" width="400" />
<img src="/images/chapter-13/basic-search-suggestions.png" alt="搜索建议" width="360" />
- 使用数据收集服务生成的频率表。
- 处理用户输入,通过字典树从频率数据中检索前 k 条建议。
- 使用缓存与高效数据结构加快查找。
- 例如用户输入“tw”时,展示查询次数最多的 5 个匹配词。
第三步:详细设计
字典树数据结构
字典树是一种树形数据结构,可高效存储和检索查询字符串。
主要特点
**紧凑存储:**按层级表示前缀,减少重复。
**频率信息:**在节点中保存查询热度。
获取搜索次数最多的前 k 个查询:
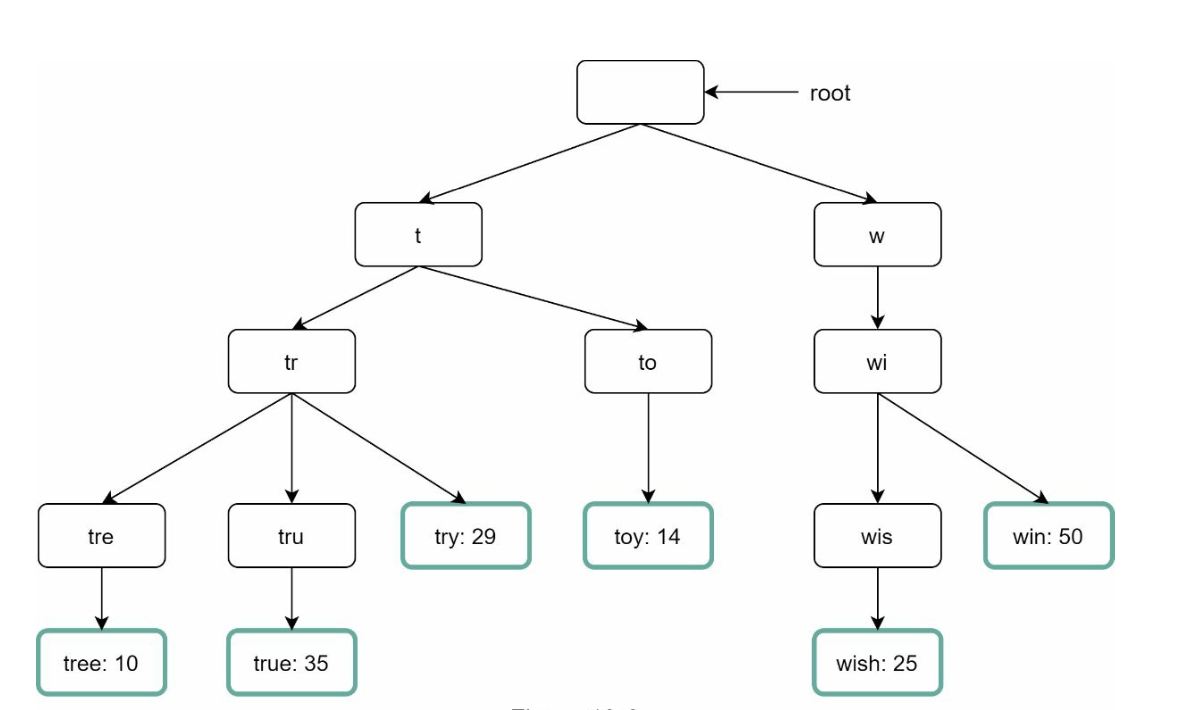
- 找到输入对应的前缀节点。
- 遍历该节点的子树,找出所有有效查询。
- 排序后取前 k 个。
优化:
在每个节点缓存前 k 条查询,避免每次遍历整棵子树。
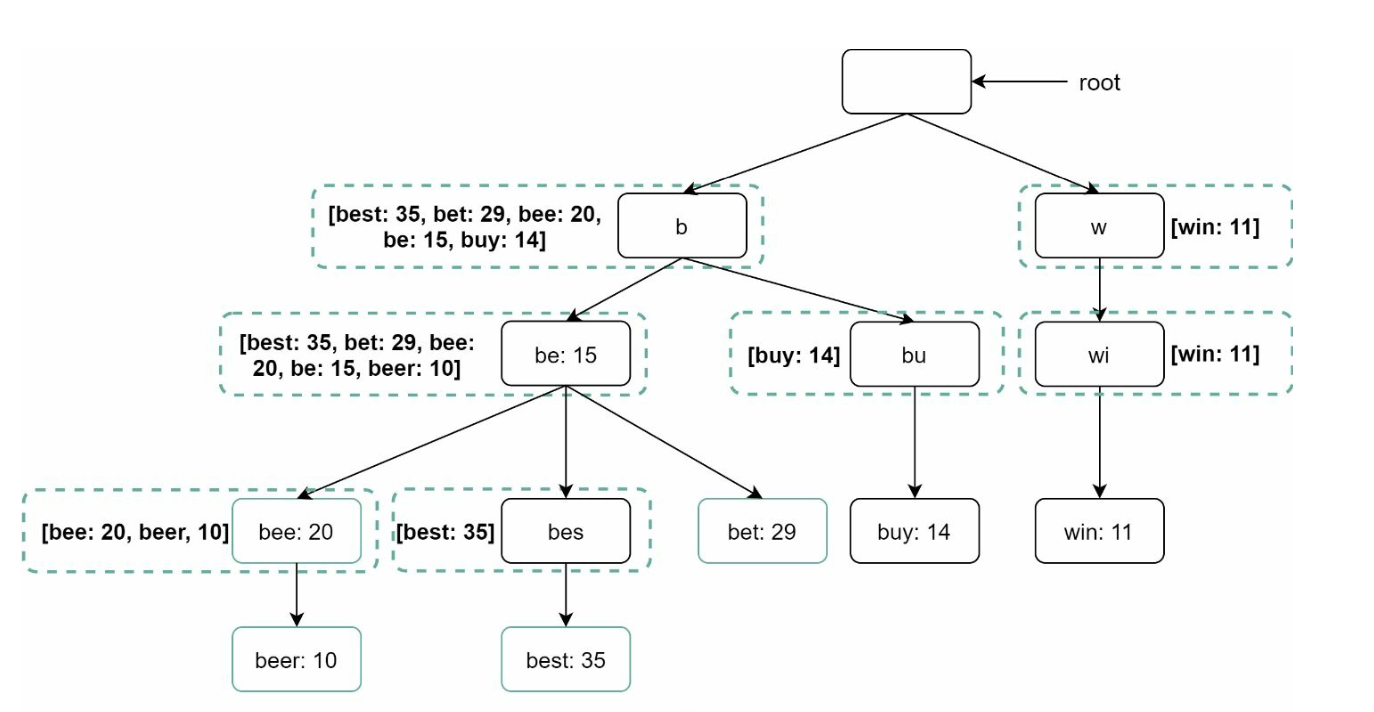
限制前缀长度以缩小搜索范围,因为用户很少输入很长的查询(如 50 个字符)。
字典树操作
创建:
- 每周根据聚合后的查询数据构建。
- 数据来自分析日志或数据库。
**更新:**通常不实时更新,而是每周用新版本替换旧版本。
删除:
<img src="/images/chapter-13/delete-kv.png" alt="从键值存储删除" width="500" />- 过滤器会移除不需要或有害的建议,例如仇恨言论。
- 过滤层允许按不同规则灵活移除结果。
- 被过滤的建议随后从数据库中异步物理删除。
查询处理流程
- 前缀搜索:
- 找到与用户输入对应的前缀节点。
- 遍历子树,收集有效建议。
- Top-k 排序:
- 在每个节点缓存前 k 条建议,减少排序开销。
- 构造响应:
- 利用缓存数据快速生成结果。
优化
- **节点缓存:**保存前 k 条查询,避免重复遍历。
- **限制前缀长度:**将长度限制在较小值(如 50 个字符),加快查找。
- **AJAX 请求:**使用轻量级异步请求取得实时结果。
- **浏览器缓存:**缓存常用查询的自动补全结果。
数据收集流水线
概要设计中,每次用户输入查询都会实时更新数据。对于大规模系统,这种做法不切实际。
- 用户每天可能发起数十亿次查询,不可能每次都更新字典树。
- 字典树构建完成后,热门建议通常不会频繁变化。
改进设计
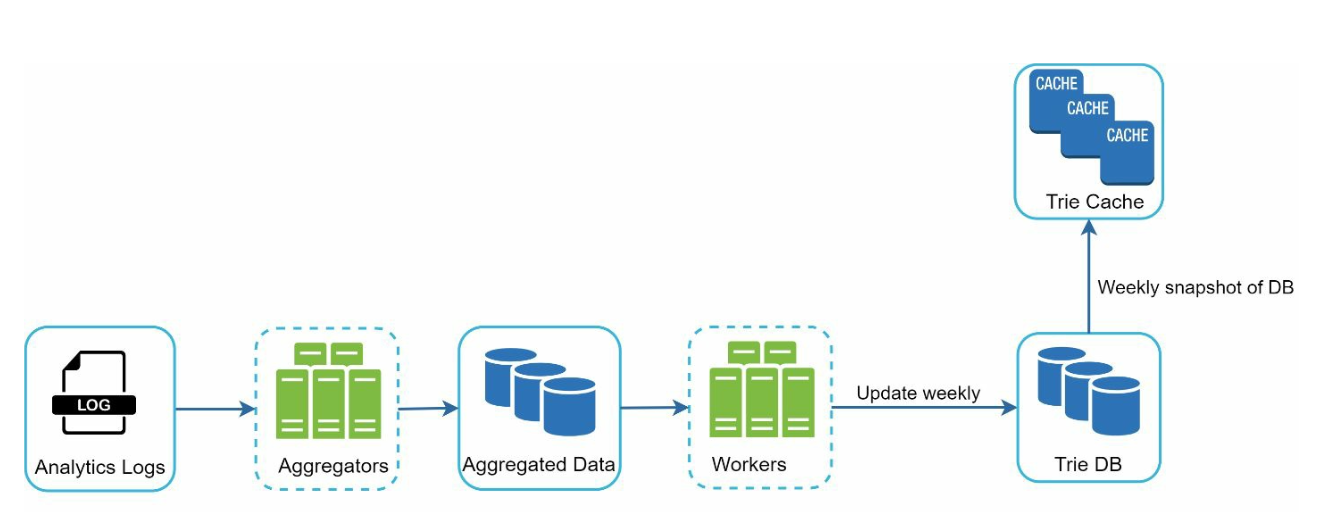
- 分析日志:
- 以日志形式保存原始查询数据,供每周聚合。
- 日志只追加,不建立索引。
- 聚合器:
- 将日志处理成频率表,用于构建字典树。
- 对 Twitter 等实时应用,可缩短聚合周期。
- 其他场景较低频率的聚合(如每周一次)即可满足需求。
- 工作进程:
- 异步重建字典树,并保存到持久化存储。
- 存储选择:
- **字典树缓存:**分布式缓存,在内存中保存字典树,支持快速读取。
- 字典树数据库:
- **文档数据库(如 MongoDB):**每周生成新树后,可定期生成快照、序列化并保存。
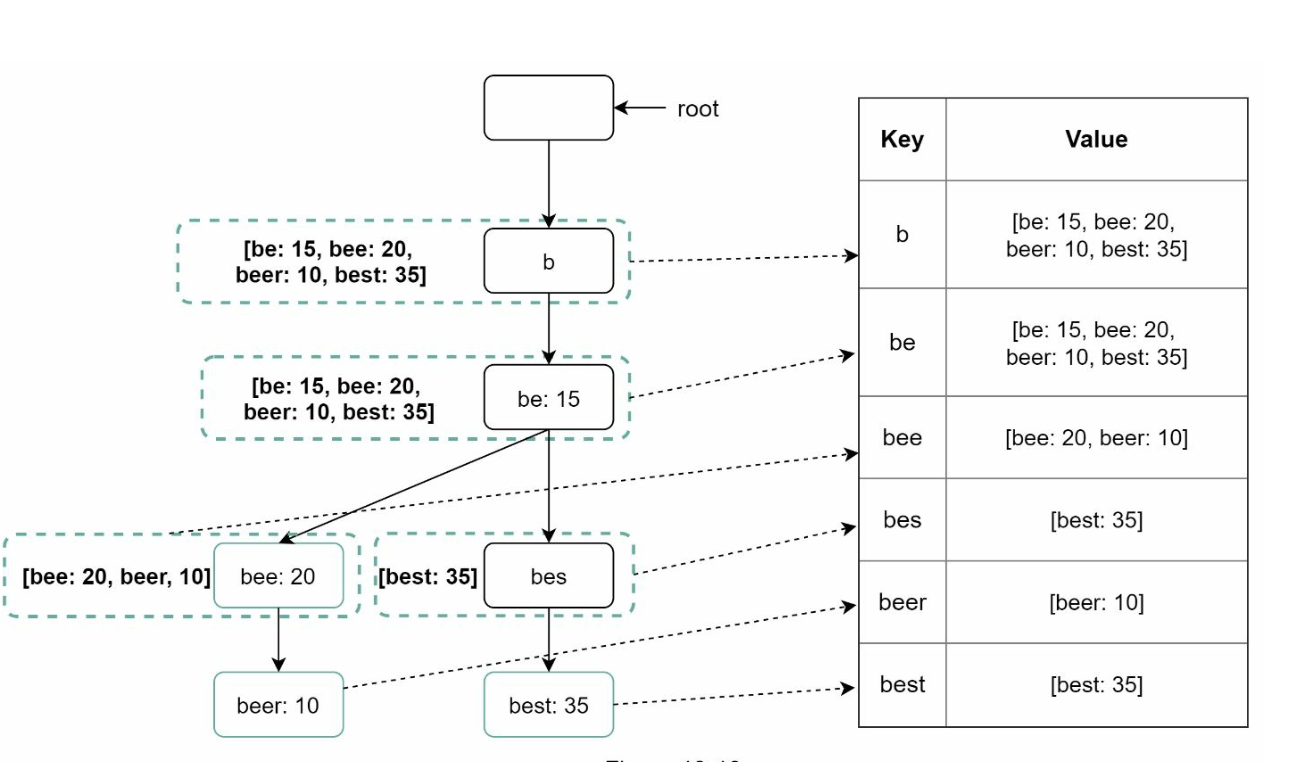
- 键值存储:
将前缀映射到节点数据,便于快速访问。
字典树中的每个前缀对应哈希表中的一个键。
每个节点的数据对应哈希表中的一个值。
扩展性
分片:
- 按前缀范围(如
a-m、n-z)将节点分布到不同服务器。 - 若分布不均,可进一步细分(如
aa-ag、ah-an)。
- 按前缀范围(如
负载均衡:
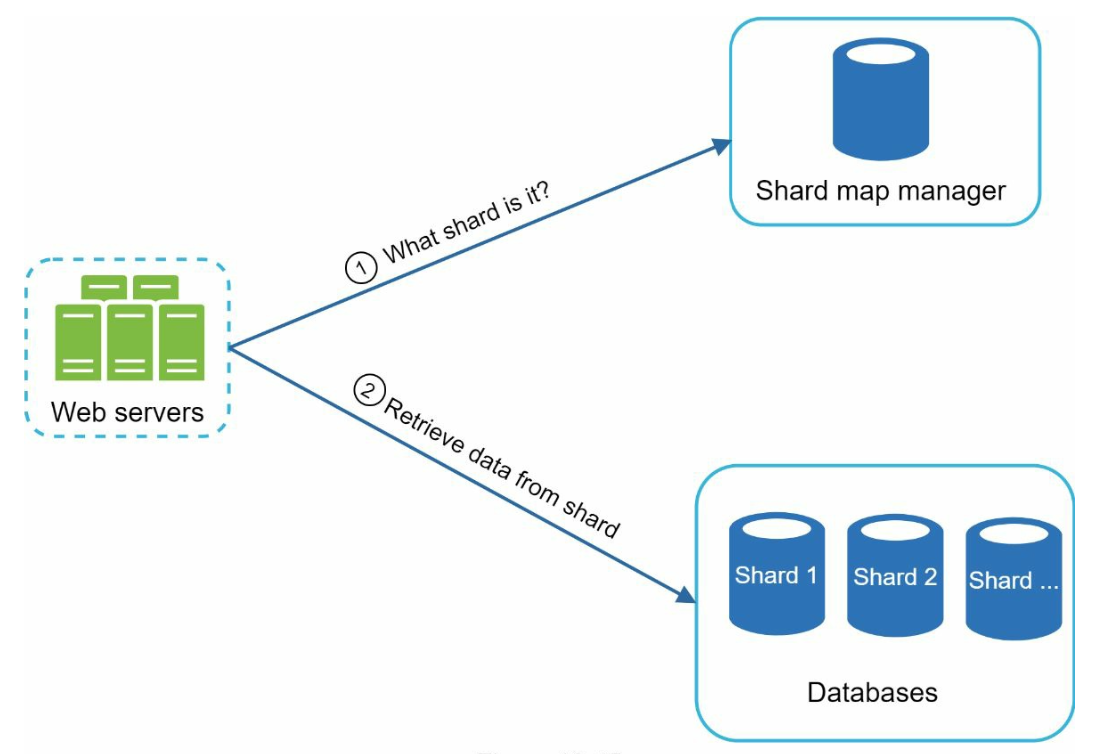
- 使用分片映射管理器将请求路由到对应服务器。
第四步:高级功能
多语言支持
- **Unicode 字符:**使用 Unicode 支持非英语语言。
- **按国家或地区建树:**为不同国家或地区构建独立字典树。
热门趋势查询
- 通过动态更新字典树节点或提高近期查询的权重,处理实时热点事件。