第 1 章:从零扩展到数百万用户
引言
将系统扩展到支持数百万用户,是一个需要持续改进和优化的复杂过程。本章从单台服务器出发,逐步扩展架构,以应对数百万用户。
第 1 节:单服务器架构
起初,所有组件(Web 应用、数据库、缓存)都运行在同一台服务器上。
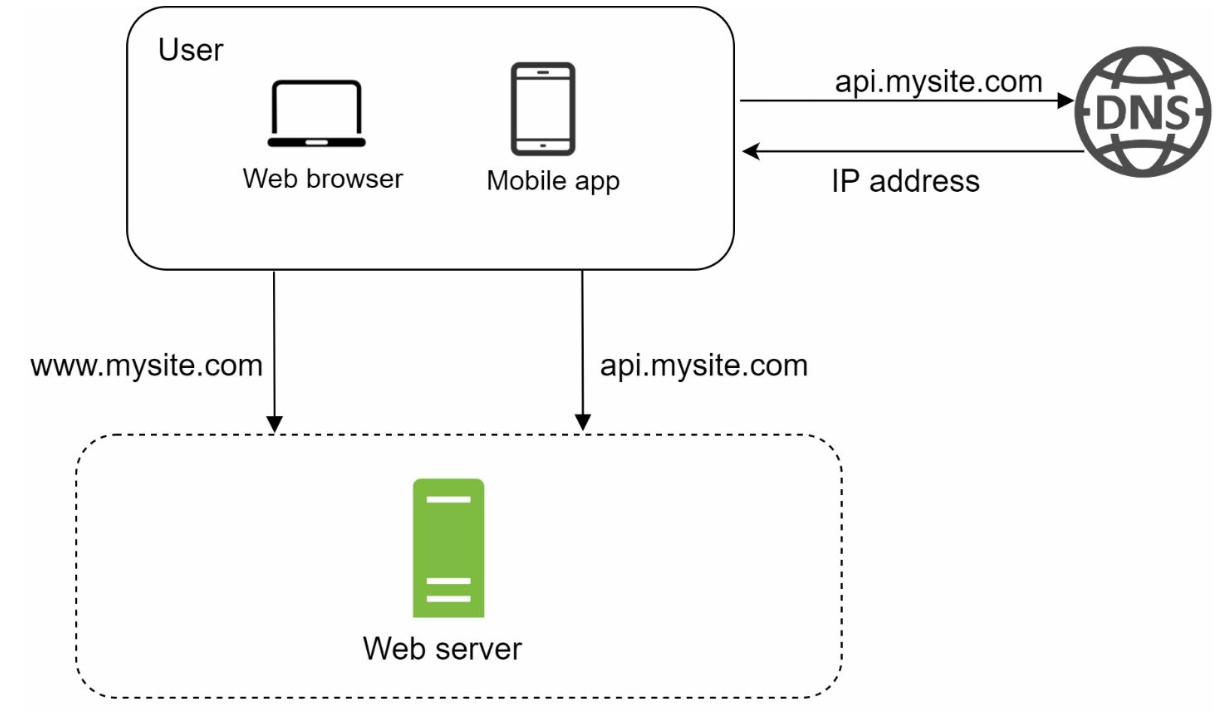
请求流程
- 用户通过域名(例如
api.mysite.com)访问应用,DNS 将域名解析为 IP 地址。 - 浏览器或移动应用获得 Web 服务器的 IP 地址。
- 客户端向 Web 服务器发送 HTTP 请求,服务器返回 HTML 或 JSON 响应。
流量来源
- Web 应用: 使用服务端语言(如 Python、Java)处理业务逻辑,使用客户端语言(如 JavaScript、HTML)呈现界面。
- 移动应用: 通过 HTTP 与 Web 服务器通信,并用 JSON 进行轻量级数据交换。
第 2 节:分离数据库
随着用户增长,将数据库迁移到专用服务器,使 Web 层和数据库层可以独立扩展。
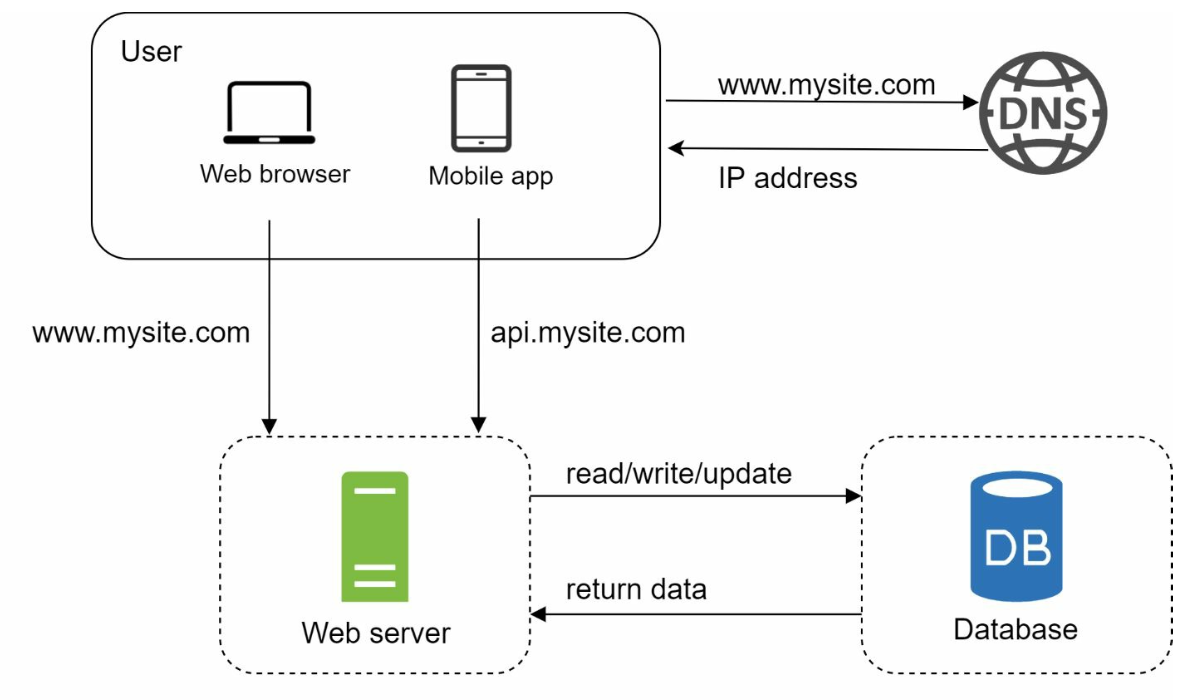
数据库选择
- 关系型数据库(SQL): 将结构化数据存储在表中,例如 MySQL、PostgreSQL。
- 非关系型数据库(NoSQL): 适合非结构化数据或低延迟需求,主要类别包括:
- 键值数据库
- 图数据库
- 列式数据库
- 文档数据库
- 以下情况可能适合非关系型数据库:
- 应用需要极低延迟。
- 数据是非结构化的,或不存在关系型数据。
- 只需要对数据进行序列化和反序列化(JSON、XML、YAML 等)。
- 需要存储海量数据。
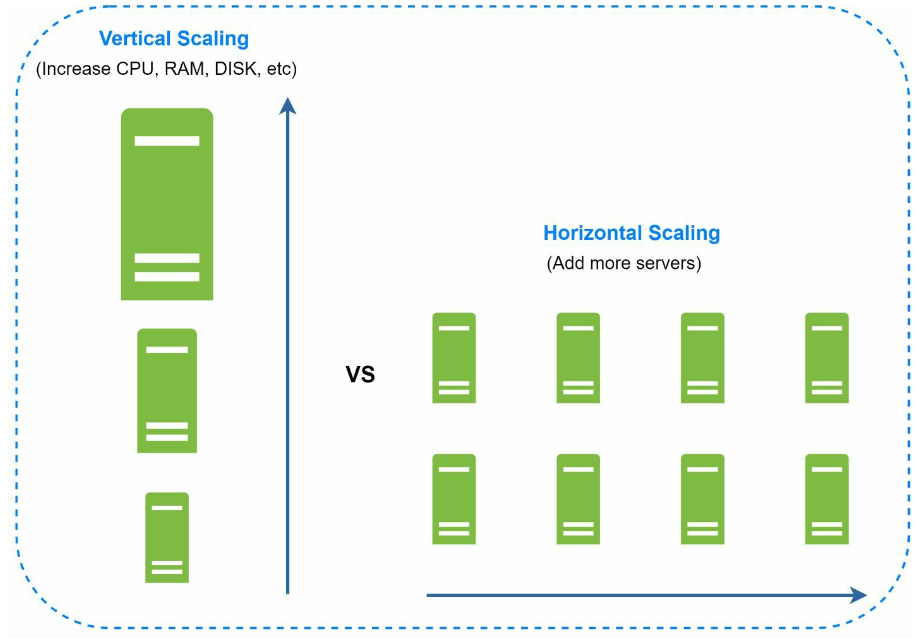
第 3 节:垂直扩展与水平扩展
垂直扩展
- 为现有服务器增加资源(CPU、内存)。
- 受硬件上限约束,且缺少冗余。
水平扩展
- 向服务器集群增加机器,更适合大规模系统。
- 使用负载均衡器在服务器之间分发请求。
第 4 节:负载均衡器
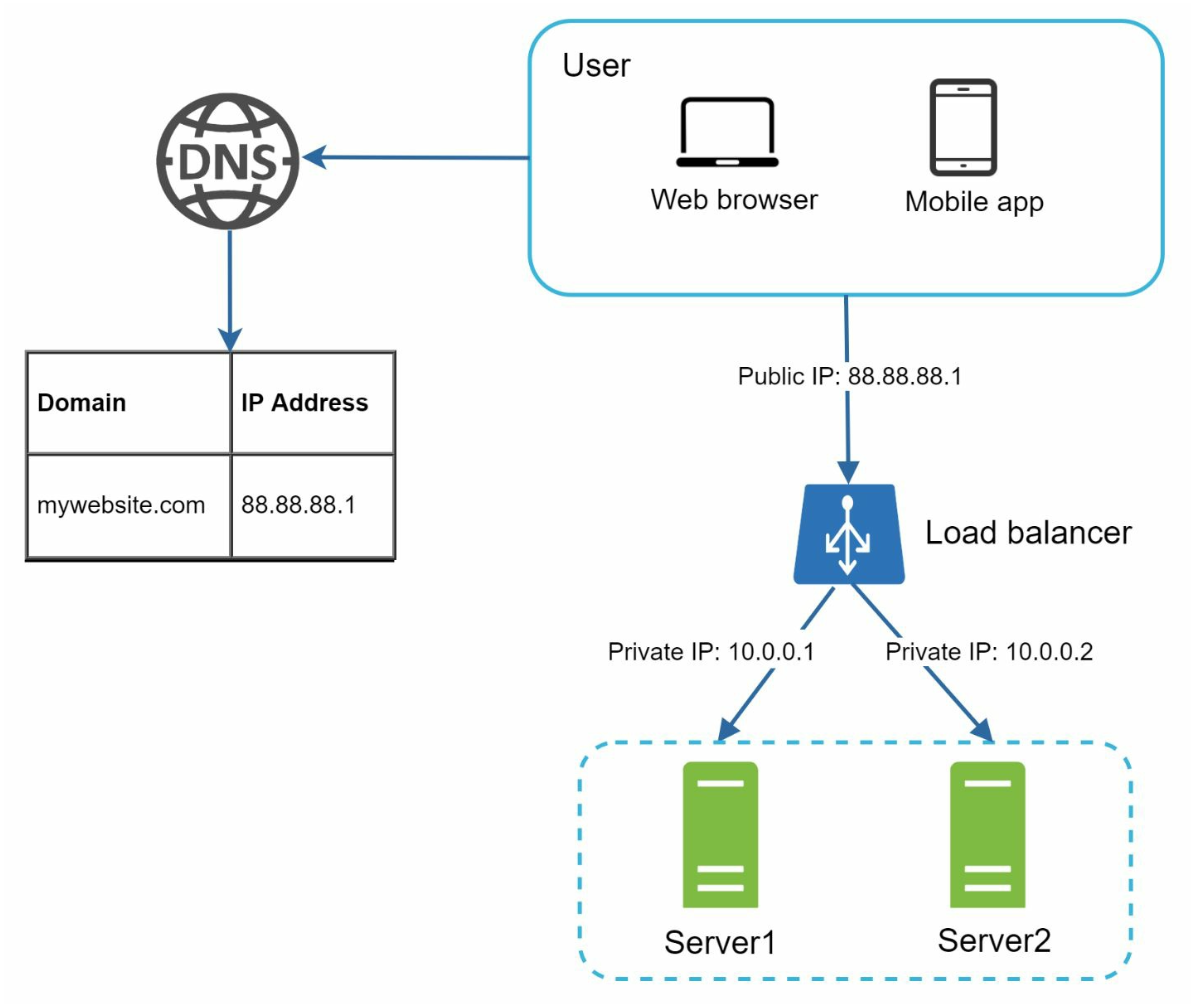
负载均衡器将流量分配到多台服务器,带来以下好处:
- 冗余:服务器离线时,流量会转发到其他服务器。
- 如果服务器 1 离线,全部流量会转发到服务器 2。
- 可扩展性:可以方便地增加服务器来应对流量高峰。
- 网站流量快速增长时,可继续添加服务器处理新增流量。
第 5 节:数据库复制
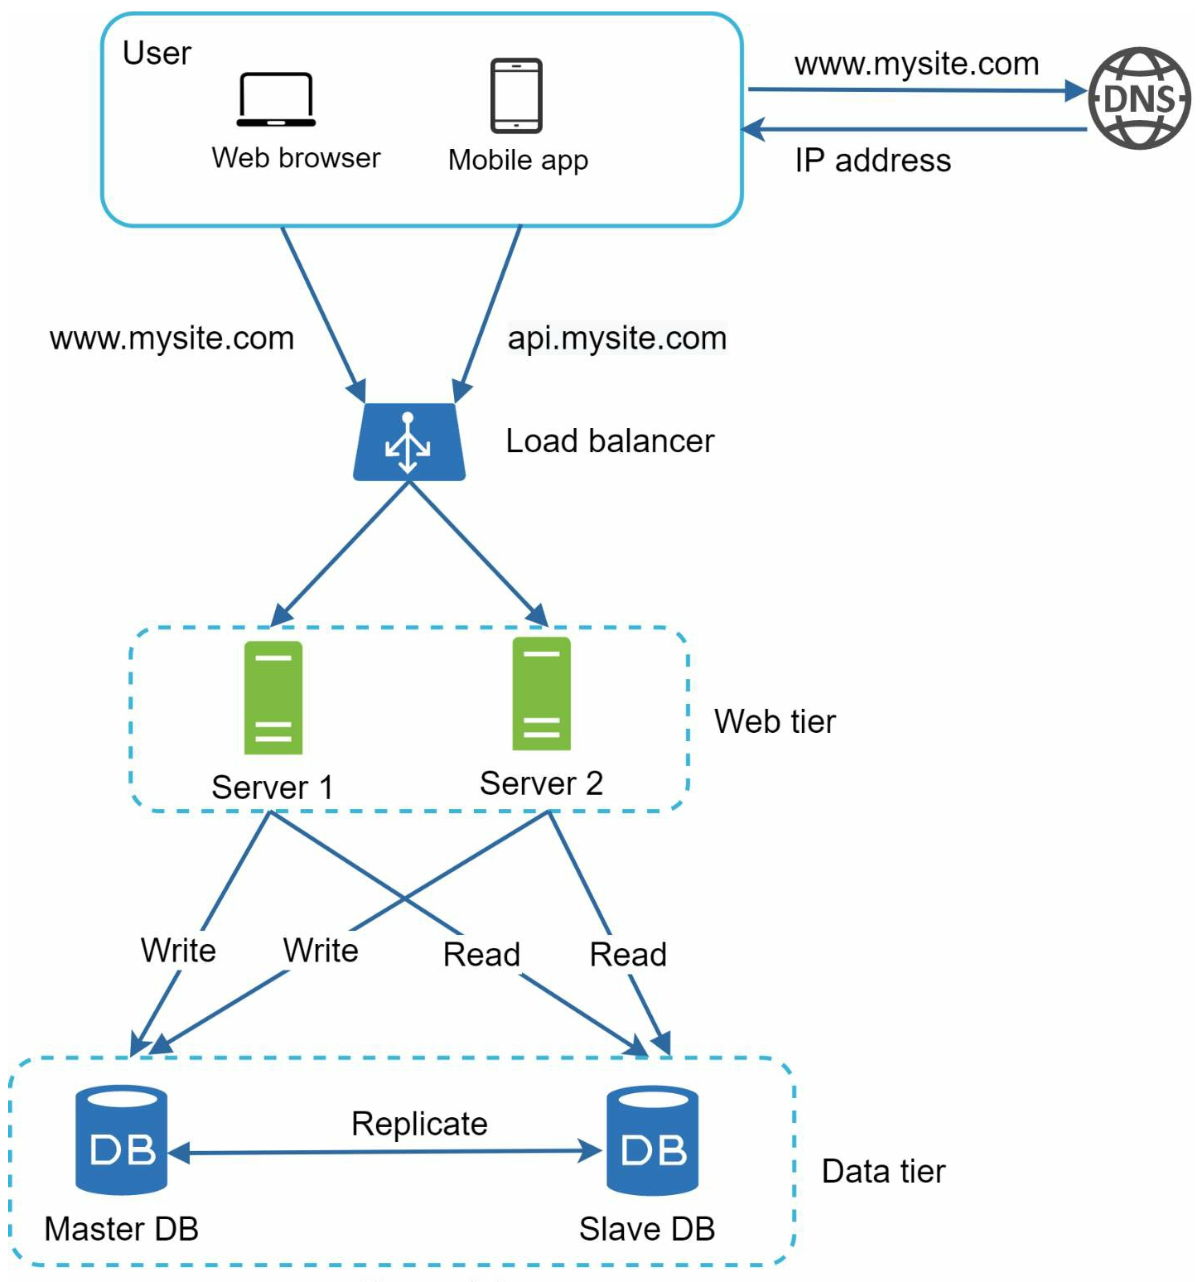
主从模型
- 主数据库: 处理写操作。
- 插入、删除、更新等修改数据的命令必须发送到主数据库。
- 从数据库: 处理读操作,提高性能和可靠性。
- 大多数应用的读写比偏高,因此从数据库通常多于主数据库。
好处
- 通过并行读取提高性能。
- 通过冗余提高可用性和数据可靠性。
故障处理
- 如果只有一个从数据库且它离线,读操作会暂时转向主数据库。
- 如果有多个从数据库,读操作会转向其他健康的从库,并用新服务器替换故障服务器。
- 如果主数据库离线,会提升一个从数据库作为新主库。
- 在生产系统中,被提升的从库可能尚未同步到最新状态,因此需要运行数据恢复脚本补齐数据;多主复制、环形复制等方法也可能有所帮助。
第 6 节:缓存
缓存把经常访问的数据保存在内存中,以减轻数据库负载。缓存层是临时数据存储层,速度远快于数据库。
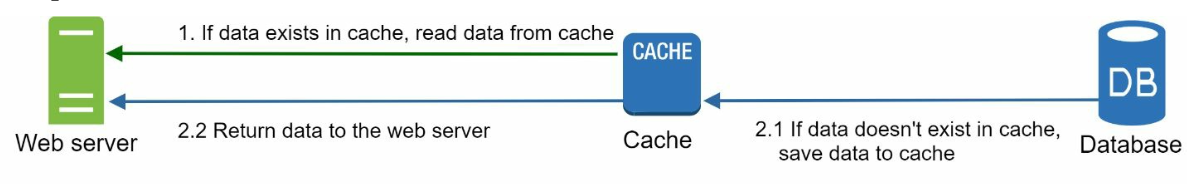
缓存注意事项
- 适用场景: 数据读取频繁、修改较少时,可考虑使用缓存。
- 过期策略: 缓存数据过期后会被移除。若没有过期策略,数据会一直占用内存。
- 一致性: 数据存储与缓存需要保持同步。由于两者的修改操作通常不在同一事务中,可能出现不一致。
- 故障缓解: 单个缓存服务器可能成为单点故障。建议在不同数据中心部署多台缓存服务器。
- 淘汰策略: 缓存满时必须移除部分条目以释放内存。LRU 是最常见的缓存淘汰策略。
第 7 节:内容分发网络(CDN)
CDN 在地理位置分散的服务器上缓存静态内容(图片、CSS、JavaScript),缩短加载时间。
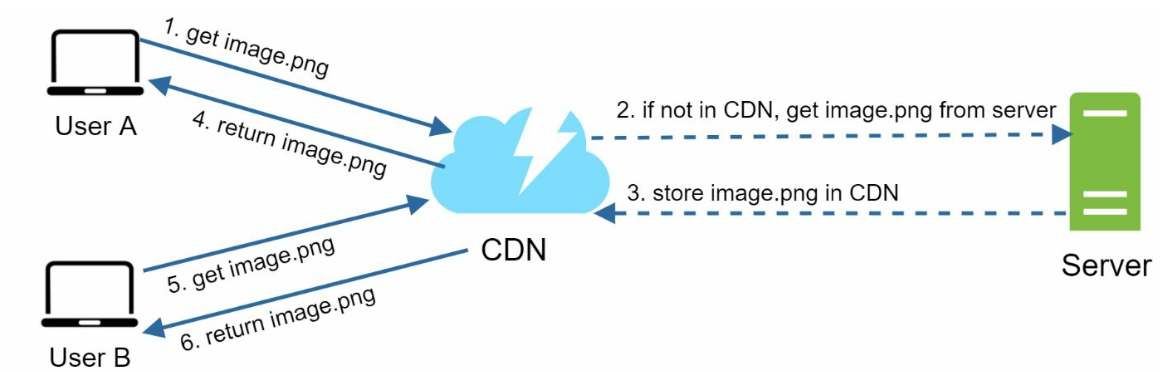
工作流程
- 用户向最近的 CDN 服务器请求内容。
- 如果该服务器没有内容,就从源站获取并缓存。
CDN 注意事项
- 成本: 第三方 CDN 服务商会针对流入和流出 CDN 的数据传输收费。
- 缓存有效期: 过期时间不宜过长或过短。
- CDN 故障回退: CDN 暂时不可用时,客户端应能检测故障并向源站请求资源。
- 文件失效处理: 文件更新后应使旧缓存失效,以便获取新版本。
第 8 节:无状态 Web 层
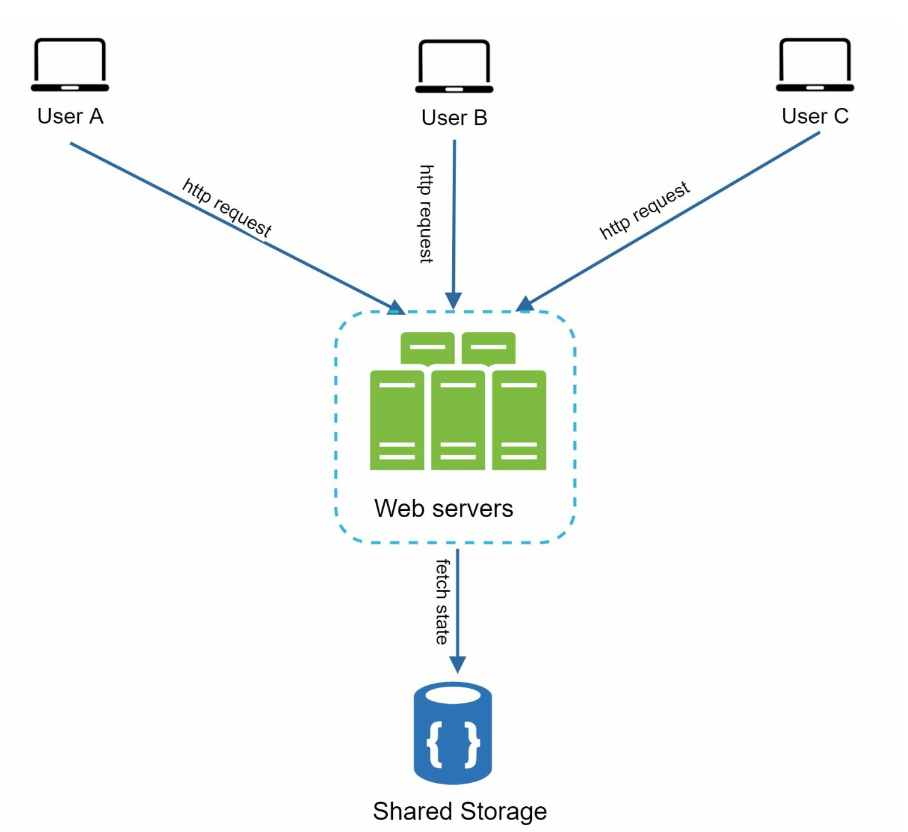
将会话数据迁移到共享数据存储后,Web 服务器就成为无状态的。这样可以:
更容易水平扩展。
根据流量自动扩缩容。
第 9 节:多数据中心架构
跨多个数据中心部署可提高可用性并降低延迟。相关策略包括:
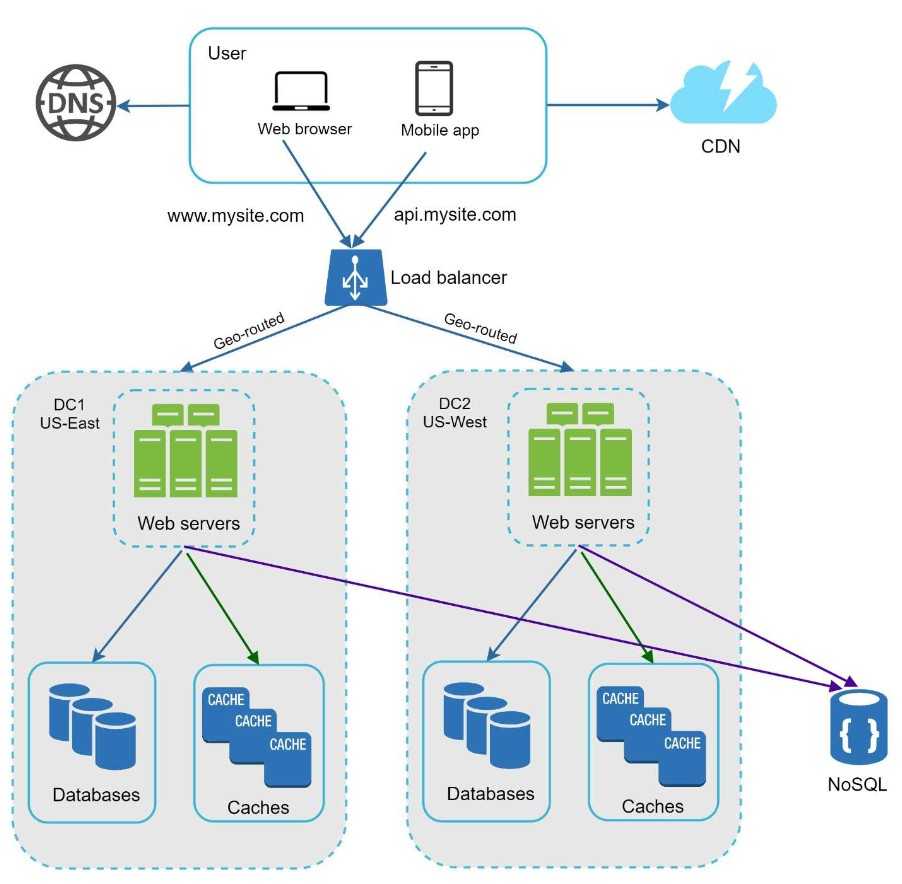
- GeoDNS 路由: 将用户引导到最近的数据中心。
- 数据复制: 在数据中心之间同步数据,避免不一致。
关键注意事项
- 流量重定向: 需要有效的工具将流量导向合适的数据中心。
- 数据同步: 常见做法是在多个数据中心间复制数据。
- 测试与部署: 自动化部署工具对于保持各数据中心服务一致至关重要。
第 10 节:消息队列
消息队列是一种支持异步通信的持久化组件,用作缓冲区并分发异步请求。
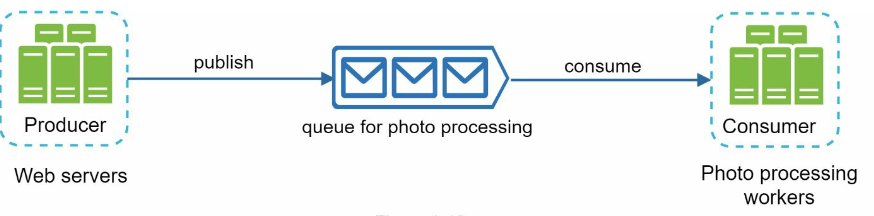
- 输入服务称为生产者或发布者,负责创建消息并将其发布到队列。
- 其他服务称为消费者或订阅者,连接队列并执行消息指定的操作。
第 11 节:日志、指标与自动化
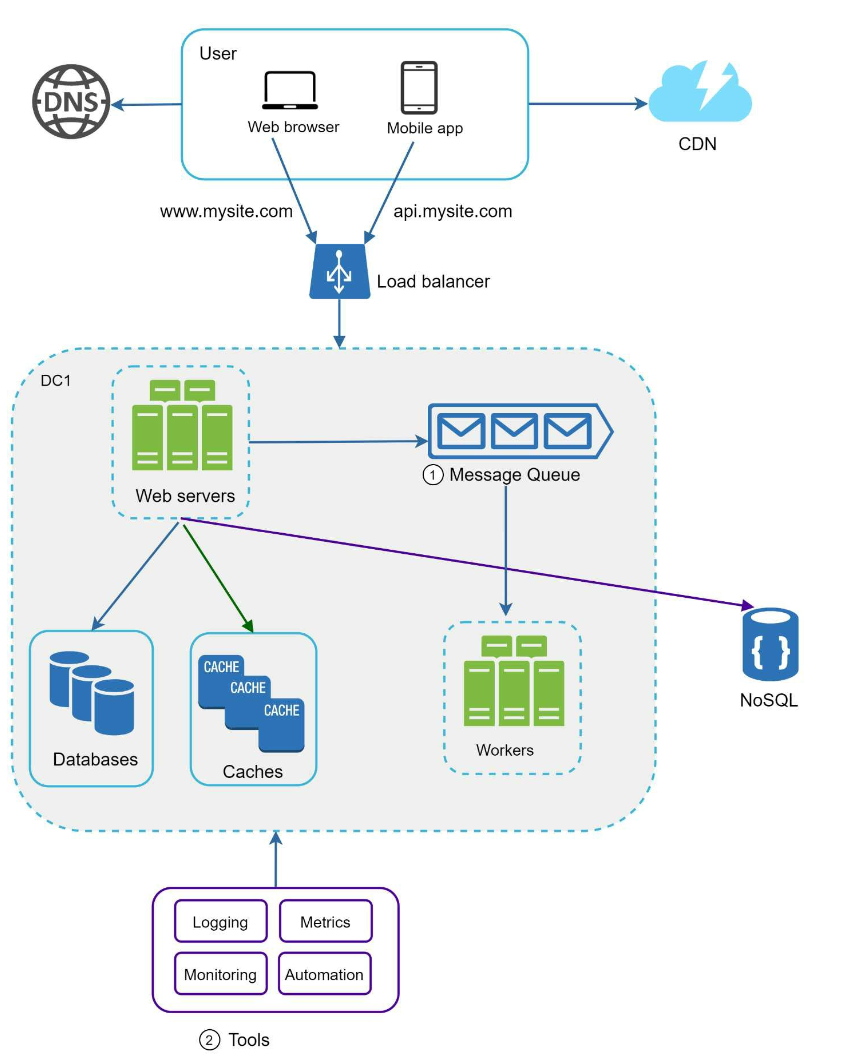
重要性
- 日志: 跟踪错误和系统健康状况。
- 指标: 帮助了解性能与用户活动。
- 自动化: 简化测试、部署和扩容。
第 12 节:数据库扩展
垂直扩展
- 增加硬件资源,但受到物理条件和成本限制。
- 还有以下缺点:
- 单点故障风险更高。
- 垂直扩展的总体成本较高。
水平扩展(分片)
- 根据键(例如
user_id)将数据分布到多个分片。- 分片将大型数据库拆成更小、更容易管理的部分。
- 每个分片使用相同的表结构,但存储的数据各不相同。
- 分片键是分片策略的关键。选键时应尽量让数据均匀分布。
挑战
重新分片: 以下情况需要重新分片:
- 数据快速增长,使单个分片无法继续容纳。
- 数据分布不均,使某些分片比其他分片更快耗尽容量。
- 一致性哈希可用于缓解这些问题。
名人问题: 对特定分片的过量访问可能使服务器过载。
- 一种解决方法是为每位名人分配专属分片。
关联查询与反规范化: 数据库分布到多台服务器后,跨分片执行关联查询会变得困难。
- 常见的应对办法是对数据库做反规范化,使查询能在单个表中完成。
总结
关键要点
- 保持 Web 层无状态。
- 在各层建立冗余。
- 用缓存和 CDN 优化性能。
- 通过分片扩展数据层。
- 解耦组件,保持灵活性。
本章为构建能够支持数百万用户的可扩展系统奠定了基础。