第 9 章:设计网络爬虫
简介
网络爬虫也称蜘蛛程序或机器人,用于发现和收集网页、图片、视频等网络内容。本章重点设计用于搜索引擎索引的可扩展爬虫。
网络爬虫的用途
- **搜索引擎索引:**收集网页以建立可搜索的索引,如 Googlebot。
- **网络归档:**保存网络数据以备将来使用,如美国国会图书馆的项目。
- **网络数据挖掘:**从网络数据中提取知识,如分析股东报告中的财务信息。
- **网络监测:**发现版权或商标侵权行为。
设计挑战
优秀的爬虫需要兼顾:
- **可扩展性:**通过并行处理抓取数十亿网页。
- **健壮性:**应对错误 HTML、程序崩溃和恶意链接。
- **礼貌性:**避免过多请求压垮目标服务器。
- **可扩展功能:**以较小改动支持新的内容类型。
第一步:理解问题
需求
- 每月抓取 10 亿个网页(平均每秒约 400 页,峰值 800 QPS)。
- 仅收集 HTML 内容。
- 跟踪新增和更新的网页。
- 忽略重复内容。
- 保存抓取数据 5 年,约需 30 PB 存储空间。
第二步:概要设计
组件
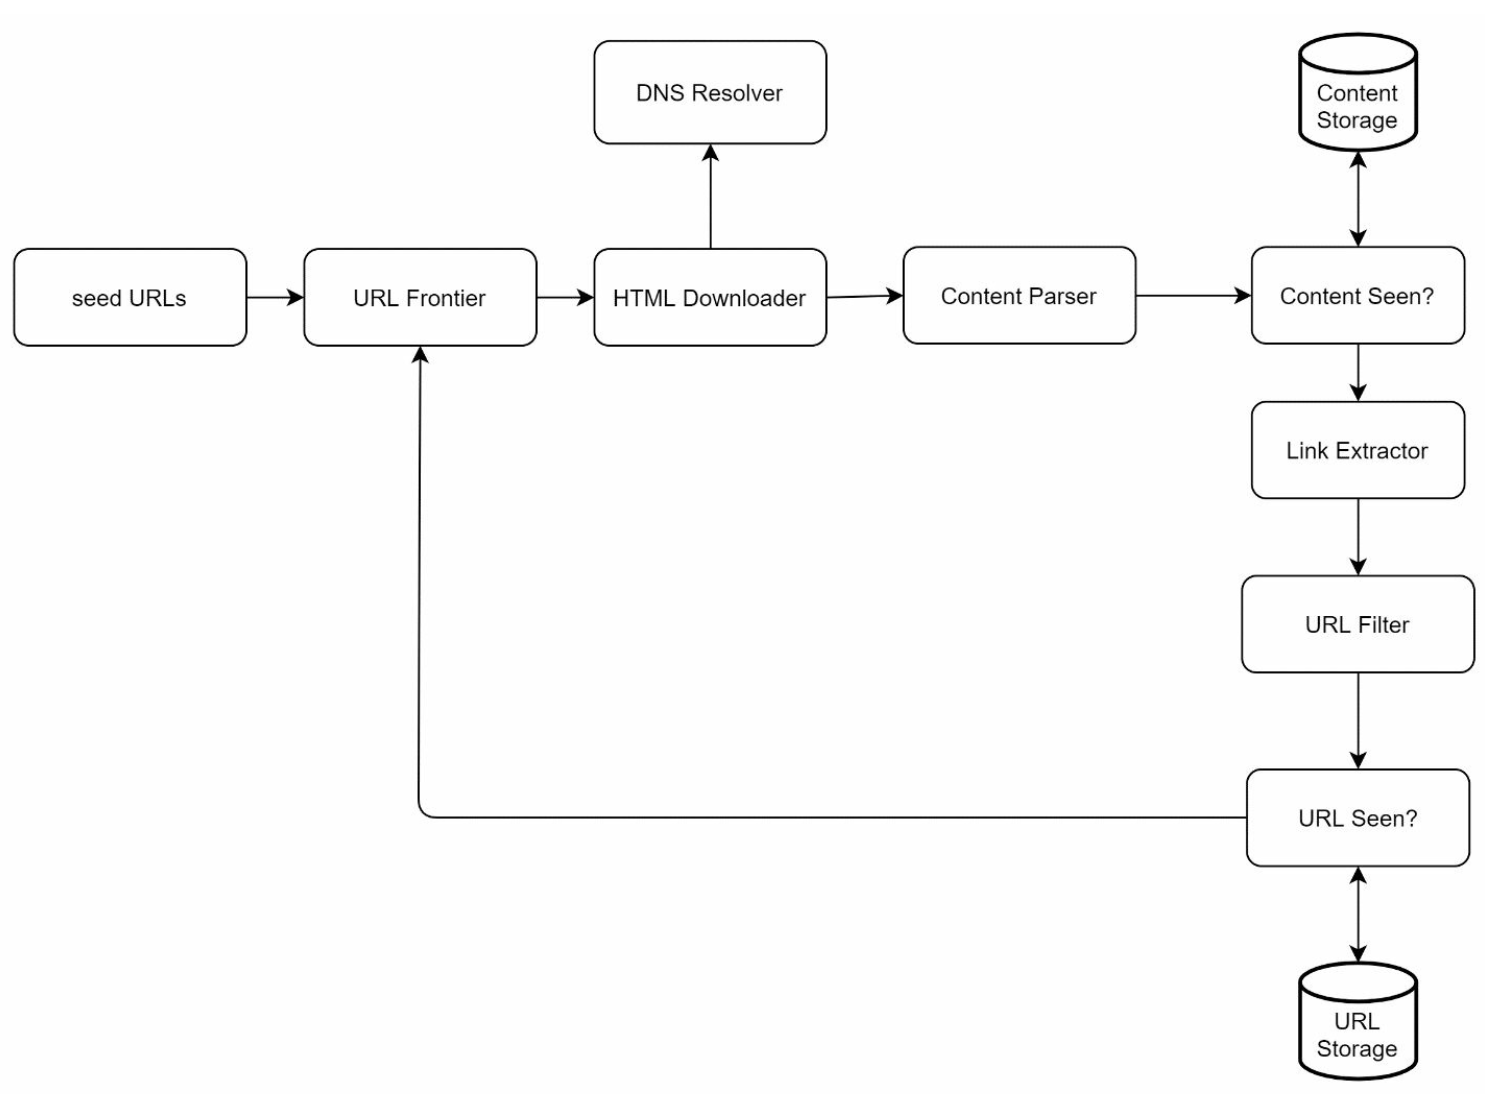
**种子 URL:**爬虫的起点。
- 需要精心选择,以便沿链接发现尽可能多的页面。
- 可按网站所在地区、热门网站或主题选择。
- 例如按地区或体育、医疗等主题分类。
**待抓取 URL 队列:**保存待下载的 URL。
- 可实现为 FIFO 队列。
**HTML 下载器:**下载队列中的网页。
**DNS 解析器:**将域名解析为 IP 地址。
**内容解析器:**验证并解析网页,丢弃格式错误的页面。
**内容去重组件:**比较网页内容的哈希值,判断是否重复。
**内容存储:**将 HTML 页面保存到磁盘;热门内容可放入内存以降低延迟。
**URL 提取器:**从解析后的页面提取新链接。
**URL 过滤器:**排除黑名单中的 URL 和无效 URL。
**URL 去重组件:**记录已访问的 URL,避免重复抓取。
**URL 存储:**保存已访问的 URL。
工作流程
- 将种子 URL放入待抓取队列。
- HTML 下载器获取 URL,并通过 DNS 解析器取得 IP 地址。
- 内容解析器验证页面,并交给内容去重组件。
- 如果内容是新的,则通过 URL 提取器提取链接。
- 过滤链接,将未见过的链接加入待抓取队列。
第三步:关键组件详解
DFS 与 BFS
- 网络可视为有向图:网页是节点,超链接(URL)是边。
- 网页层级可能很深,因此通常使用 BFS 遍历;DFS 不太适合。
- 标准 BFS 不考虑 URL 优先级,而网页的质量和重要性并不相同。
待抓取 URL 队列
礼貌性:
同一时间对每个主机只发送一个请求,两次下载之间设置延迟。
建立主机名到队列及下载工作线程的映射。
每个下载线程只从自己对应的 FIFO 队列获取 URL。
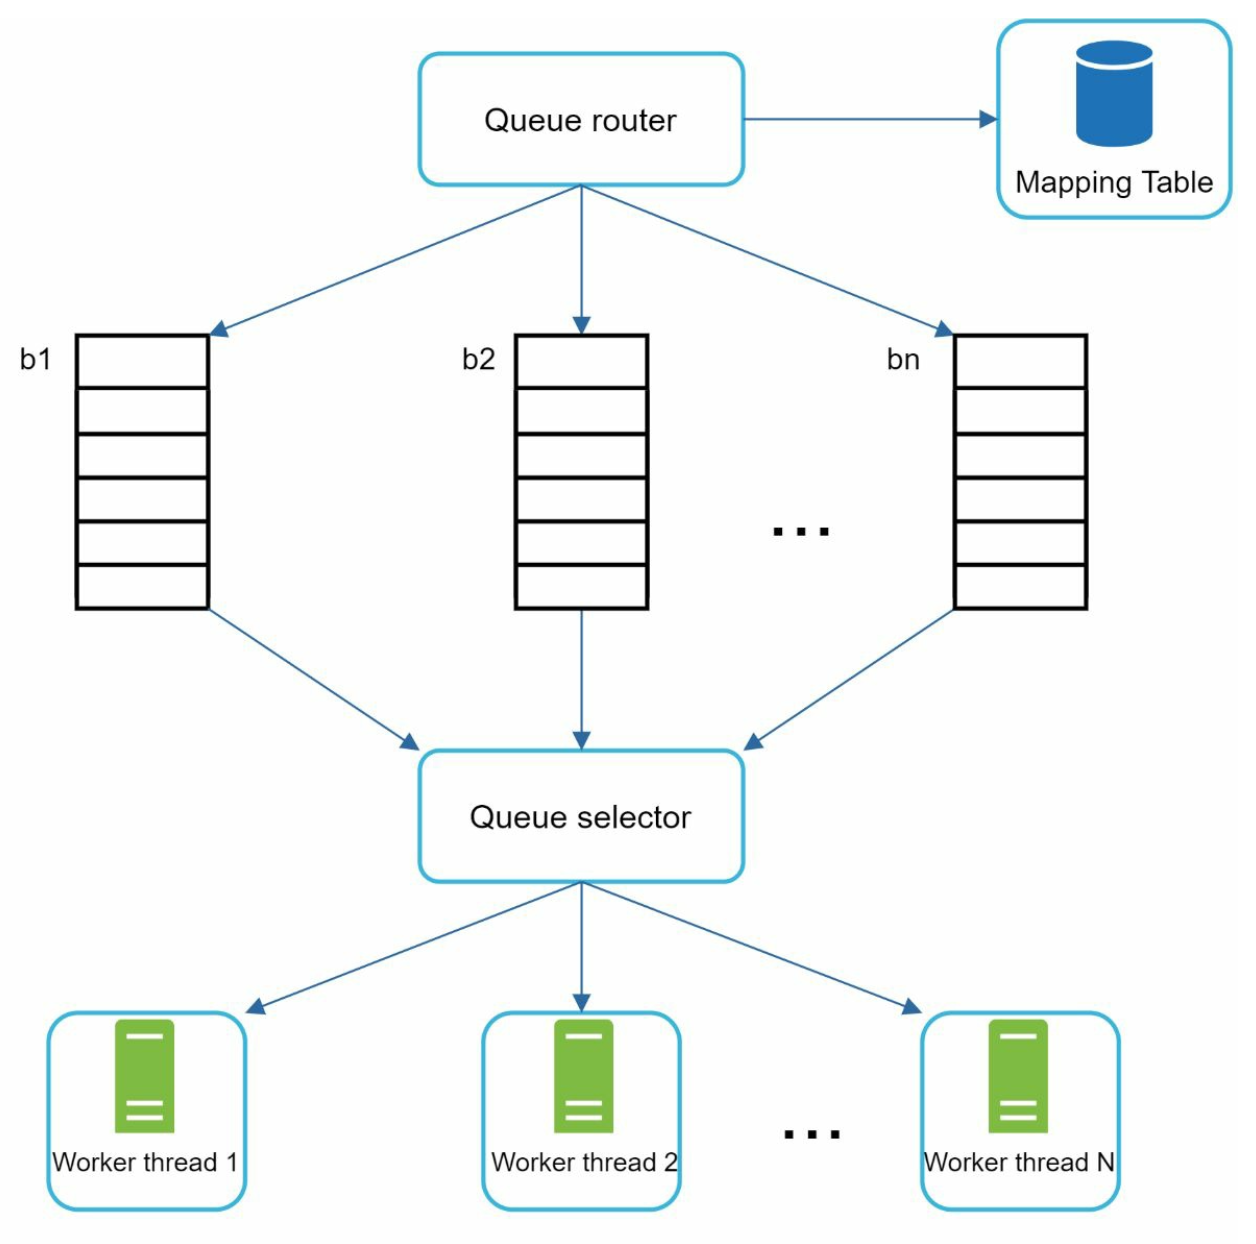
**队列路由器:**确保每个队列(b1、b2、……、bn)只包含同一主机的 URL。
**映射表:**记录主机到队列的映射。
**队列选择器:**将工作线程映射到 FIFO 队列,线程只下载该队列中的 URL。
**工作线程 1 至 N:**依次下载同一主机的网页,并可在下载任务之间等待。
优先级:
为重要页面设置更高优先级,例如依据 PageRank 或更新频率。
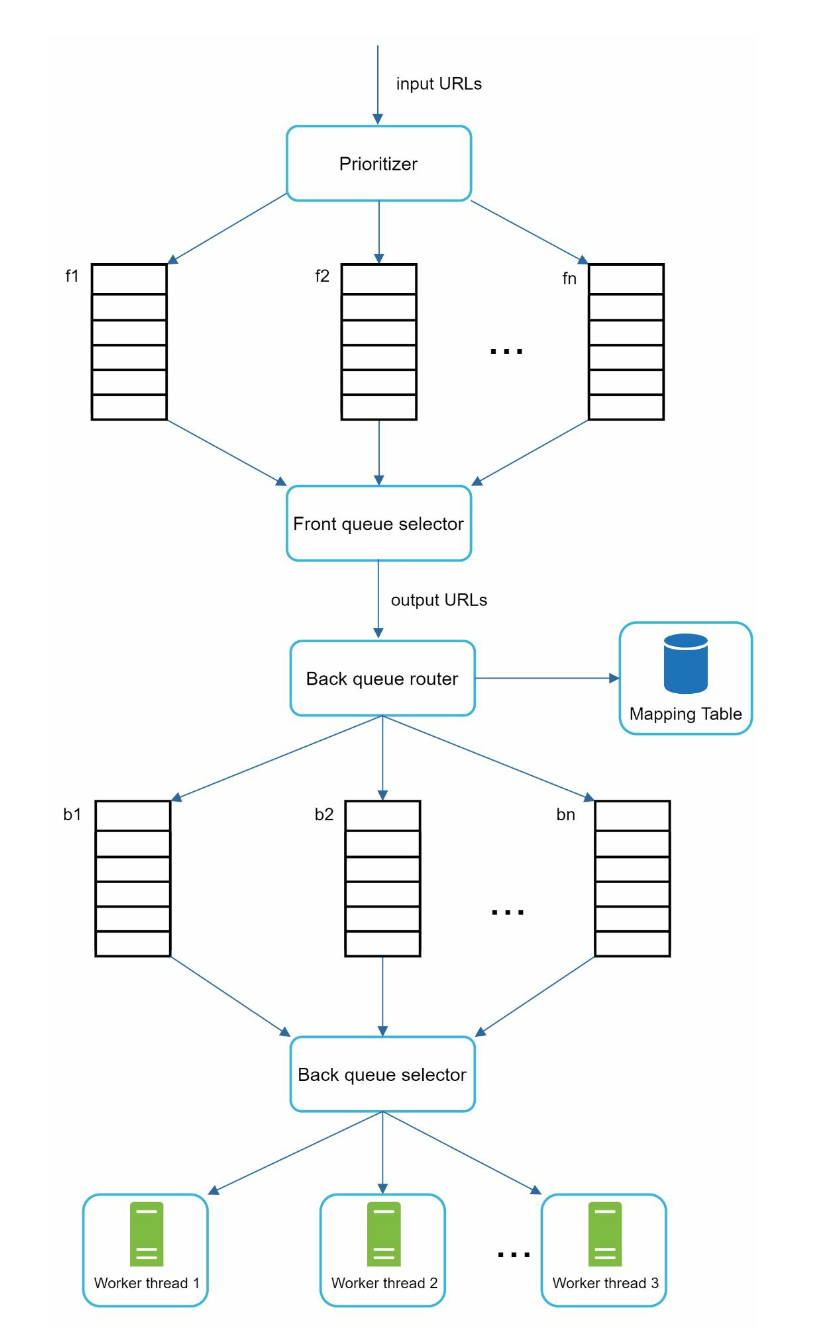
**优先级计算器:**接收 URL 并计算优先级。
**前置队列 f1 至 fn:**每个队列有指定优先级,高优先级队列有更高的选中概率。
**队列选择器:**偏向高优先级队列进行随机选择。
**前置队列:**管理优先级。
**后置队列:**管理礼貌性。
**新鲜度:**根据页面历史更新情况或重要性安排重新抓取。
HTML 下载器
- **遵守 robots.txt:**遵循文件中声明的抓取规则。
- 性能优化:
- 使用多台服务器进行分布式抓取。
- 使用 DNS 缓存,避免重复查询。
- 将抓取服务器分布到不同地理区域,加快下载。
- 设置较短超时,避免被慢速或无响应服务器拖住。
健壮性
- **一致性哈希:**有效分配服务器负载。
- **错误处理:**避免异常导致系统崩溃。
- **数据验证:**保证内容完整性。
功能扩展
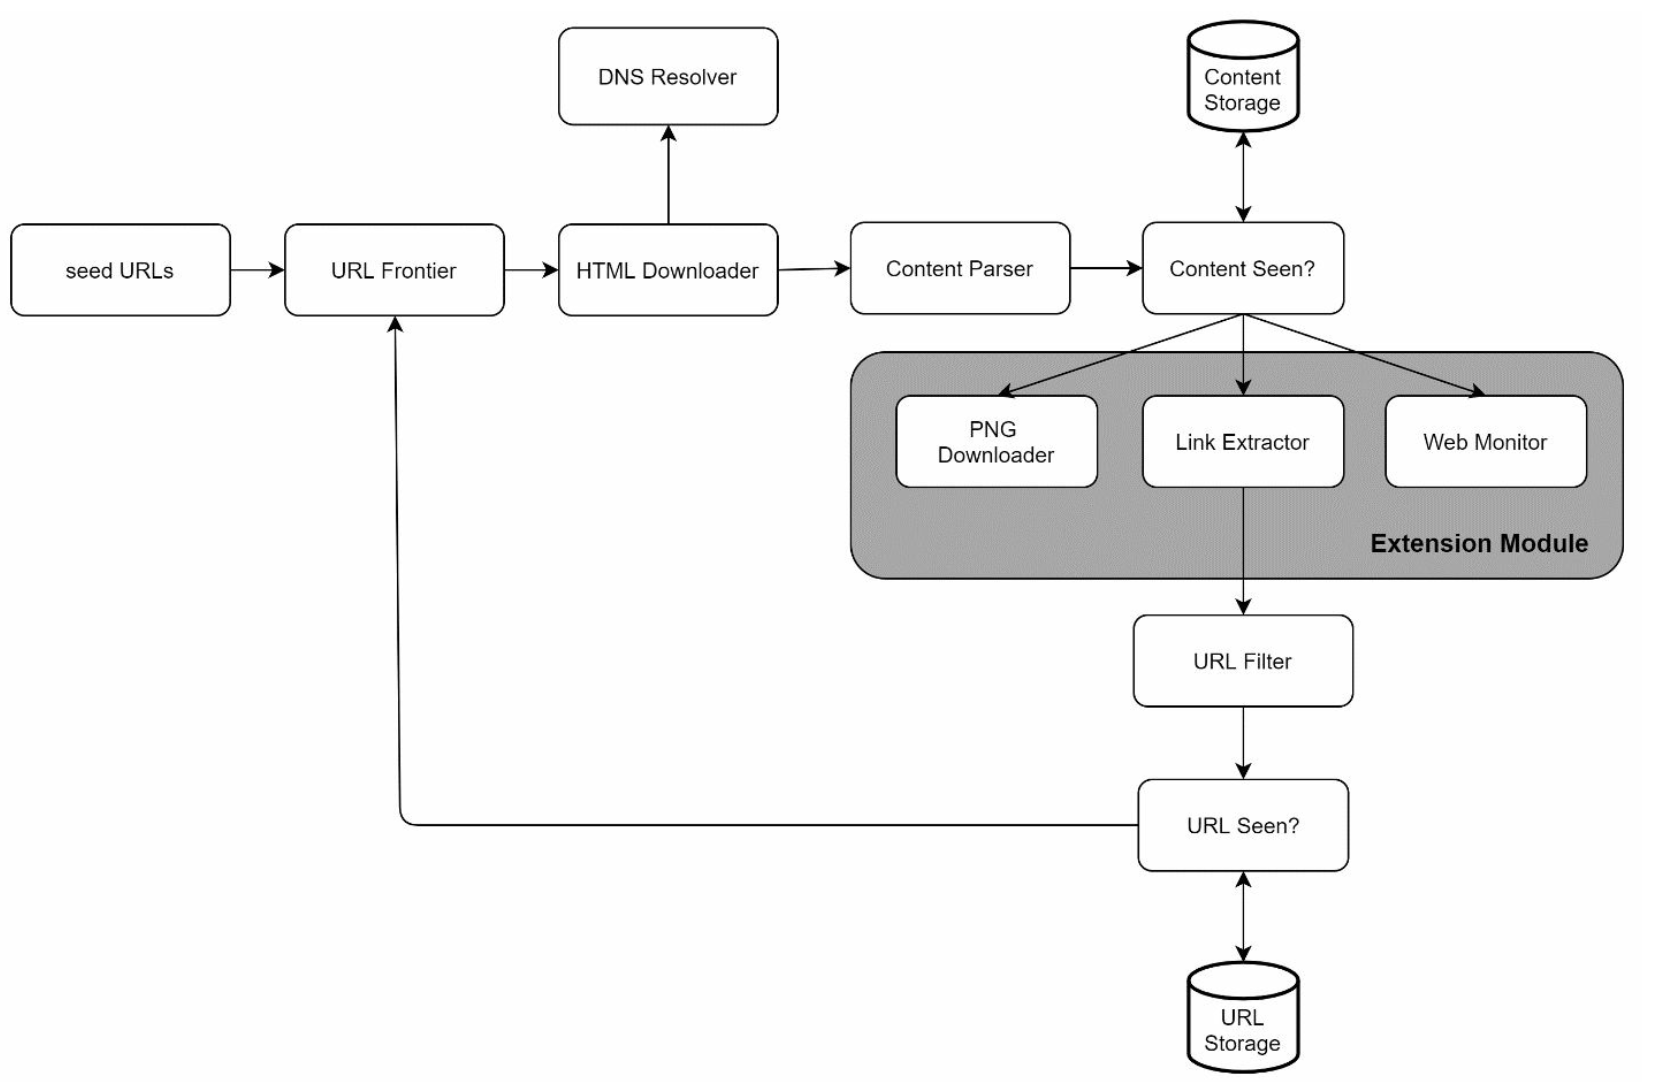
为新内容类型加入模块,如 PNG 下载器或网页监测模块。
例如,插入一个监测网页版权侵权的模块。
避免问题内容
- **重复内容:**通过哈希比较检测。
- **蜘蛛陷阱:**通过 URL 长度限制等手段避免无限循环。
- **数据噪声:**过滤广告和垃圾内容等无关数据。
第四步:总结
要点
- 网络爬虫需要兼顾可扩展性、健壮性、礼貌性和功能扩展能力。
- 礼貌性避免压垮服务器,优先级确保重要页面先被抓取。
- 高效存储与错误处理是大规模抓取的关键。
其他考虑
- **服务端渲染:**处理 JavaScript 或 AJAX 生成的动态内容。
- **反垃圾措施:**排除低质量或无关网页。
- **数据库分片:**通过复制和分片扩展数据层。
- **水平扩容:**使用无状态服务器扩展抓取任务。
- **数据分析:**收集并分析数据,获取洞察。