第 6 章:设计键值存储
引言
键值存储是一种非关系型数据库,以键值对保存数据。每个键都是唯一的,可用它访问对应的值。本章介绍如何设计可扩展、高可用的分布式键值存储,支持以下操作:
put(key, value):写入数据。get(key):读取数据。
设计特点
- 键值对较小(<10 KB)。
- 支持海量数据、高可用性和可扩展性。
- 自动扩容,一致性可调。
- 低延迟。
单服务器键值存储
实现
- 使用哈希表在内存中保存键值对。
- 可采用以下优化:
- 压缩数据。
- 将访问频率较低的数据存入磁盘。
局限
单台服务器的内存有限,因此要实现可扩展性,需要采用分布式方案。
分布式键值存储
分布式键值存储将数据分区存放在多台服务器上,必须处理 CAP 定理描述的权衡。
CAP 定理
- 一致性: 所有客户端同时看到相同的数据。
- 可用性: 即使部分节点故障,系统仍响应每个请求。
- 分区容错性: 网络发生分区时,系统仍可运行。
权衡: 按 CAP 定理,三个保证中最多只能同时实现两个。
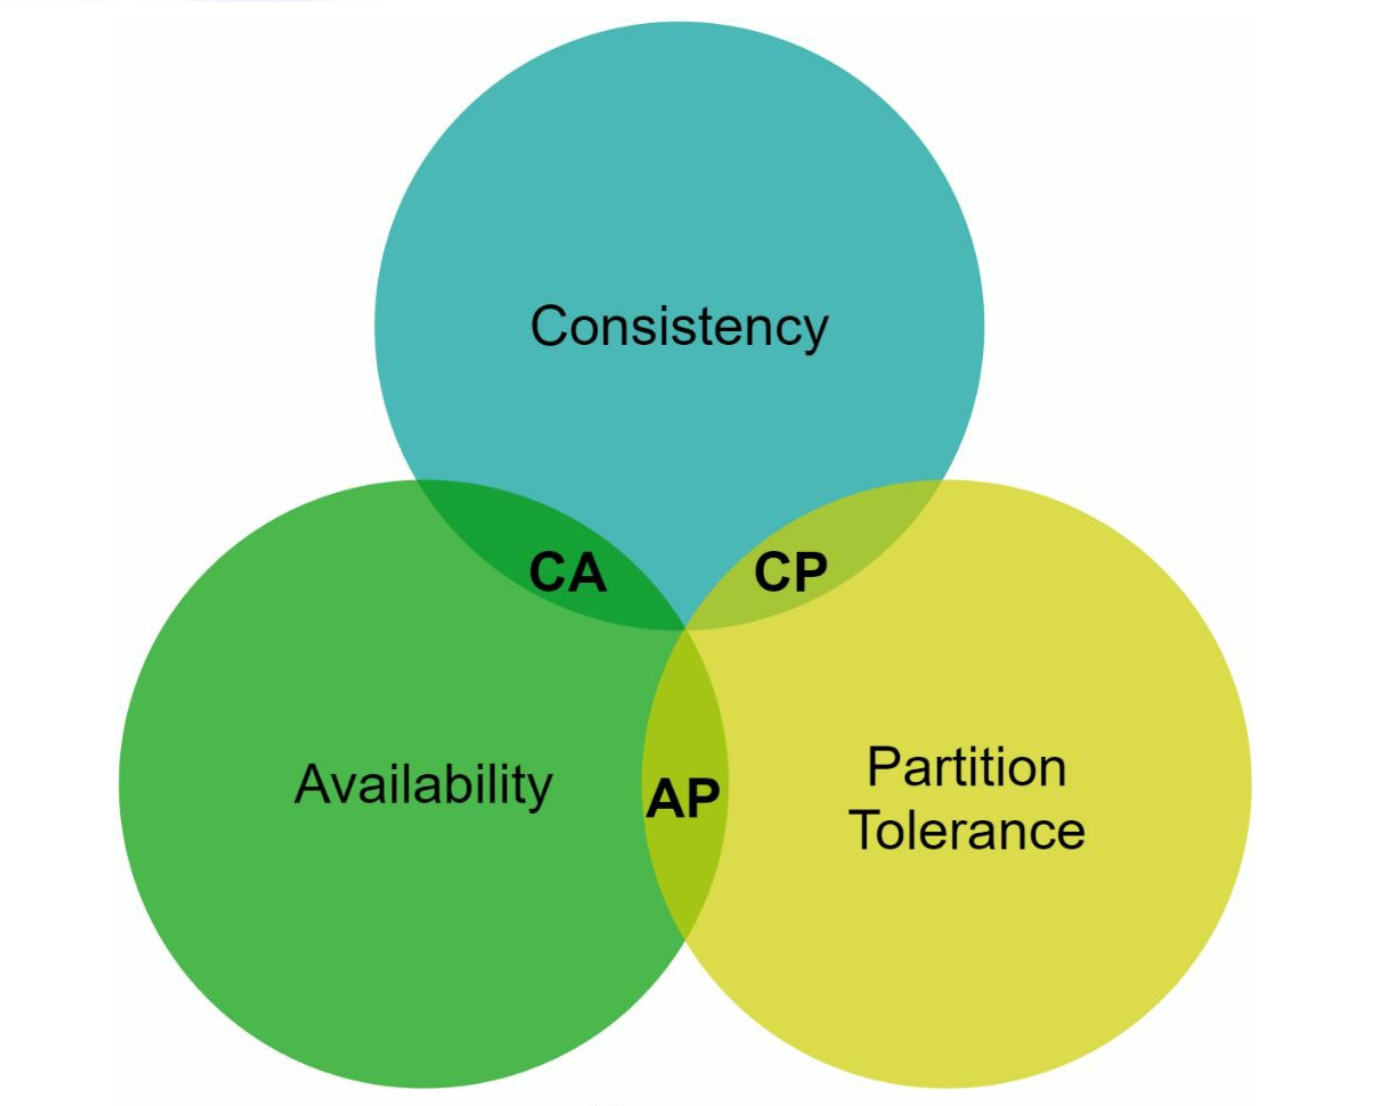
系统类型:
CP 系统: 保证一致性和分区容错性,牺牲可用性(例如银行系统)。
AP 系统: 保证可用性和分区容错性,牺牲一致性(例如采用最终一致性)。
CA 系统: 保证一致性和可用性,牺牲分区容错性。
网络故障无法完全避免,因此分布式系统必须容忍网络分区。现实应用中不存在真正的 CA 分布式系统。
分布式系统可能发生网络分区。发生分区时,必须在一致性和可用性之间选择。例如,若节点 n3 无法与其他节点通信,写入 n1 或 n2 的数据无法传到 n3;反之,如果数据写入 n3 却尚未传到 n1 和 n2,后两者就会保留旧数据。
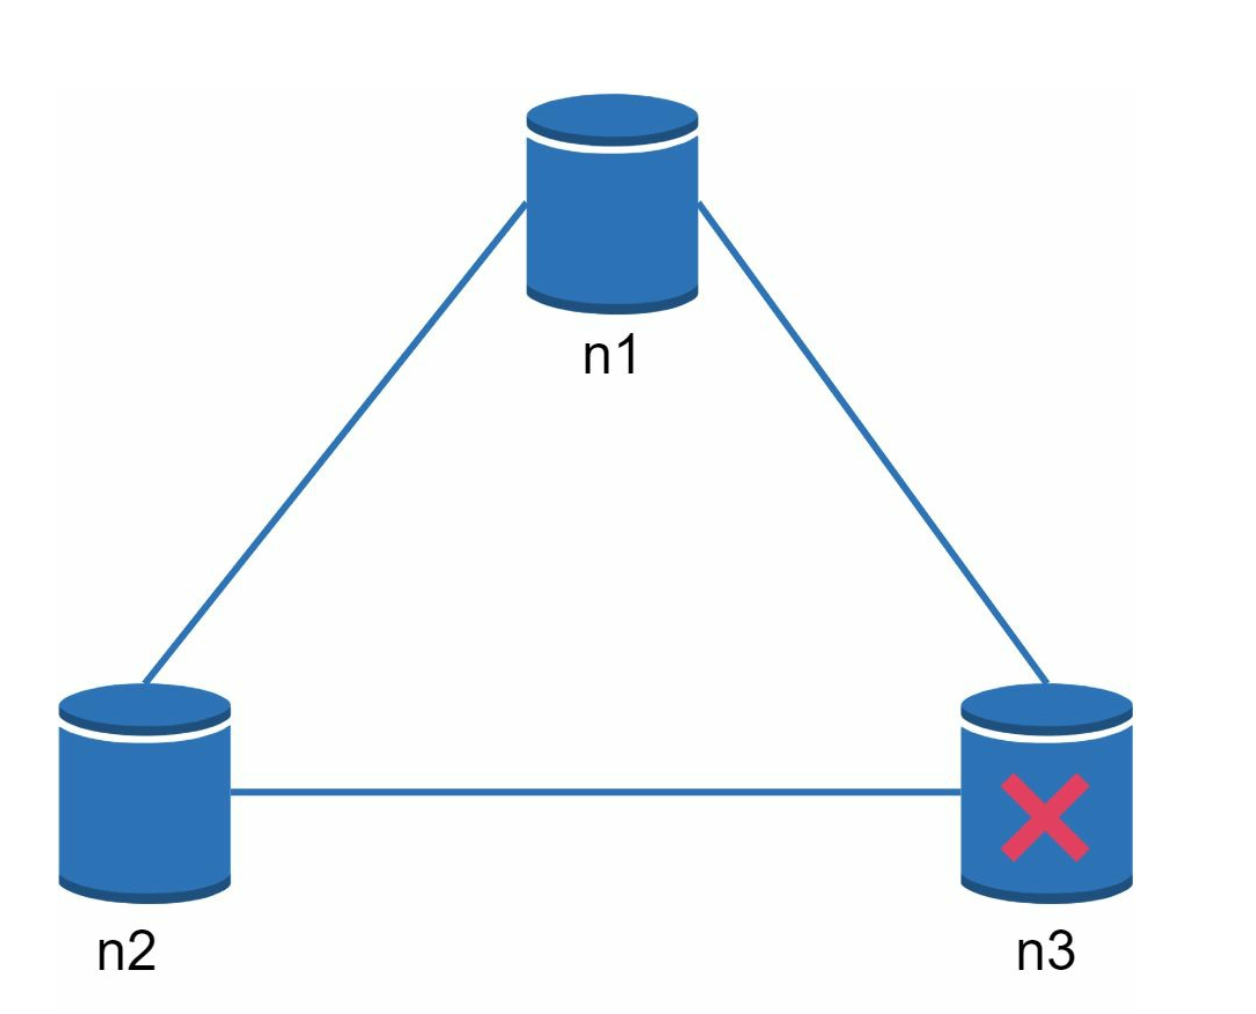
如果选择 CP,就必须阻止 n1 和 n2 的写入,以避免数据不一致。
如果选择 AP,系统继续接受读取,尽管可能返回旧数据;n1 和 n2 也继续接受写入,网络分区恢复后再与 n3 同步。
系统组件
1. 数据分区
- 技术: 使用一致性哈希,将数据尽量均匀地分布在多台服务器上。
- 优点:
- 增加或移除服务器时可自动扩缩容。
- 通过虚拟节点适应不同容量的服务器。服务器的虚拟节点数量与其容量成正比。
2. 数据复制
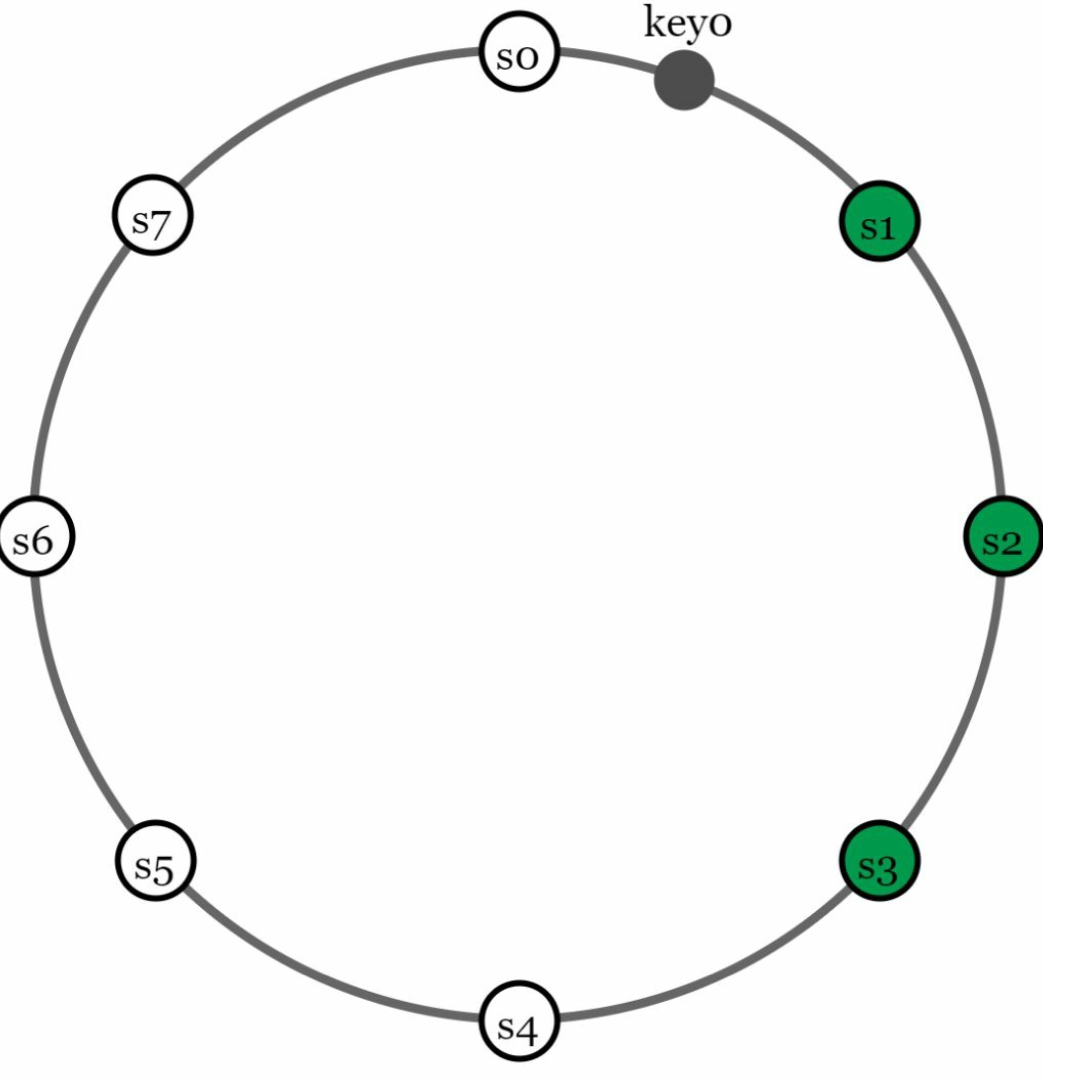
在
N台服务器上保存数据副本,以提高可用性。从服务器在环上的位置顺时针行进,选择前 N 台服务器保存副本。采用虚拟节点时,应将副本放在不同的数据中心以提高可靠性。
3. 一致性
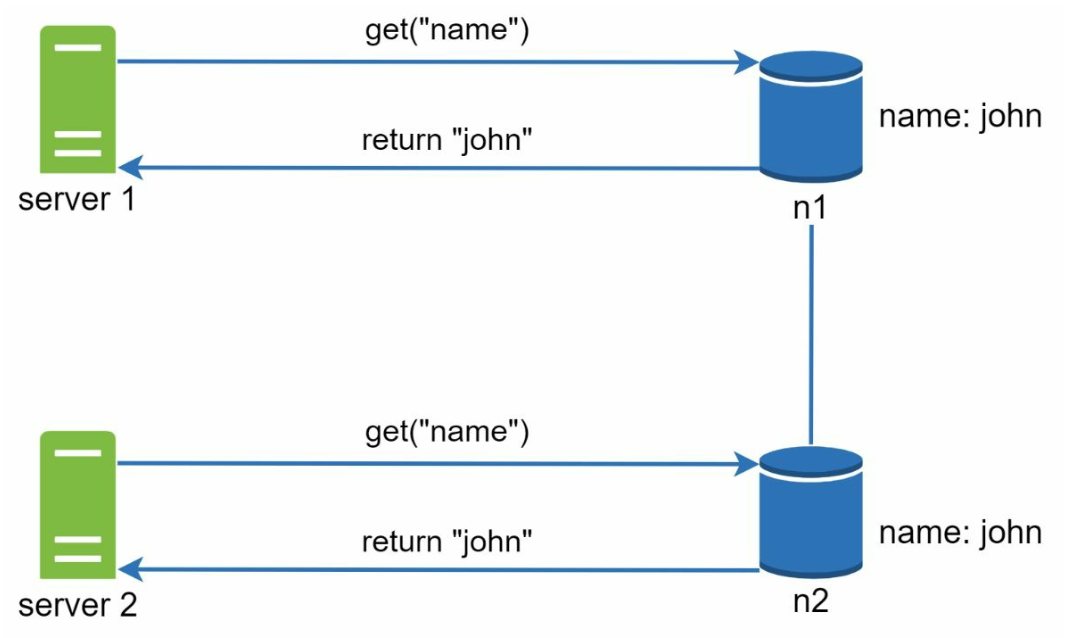
数据复制到多个节点后,副本之间必须同步。
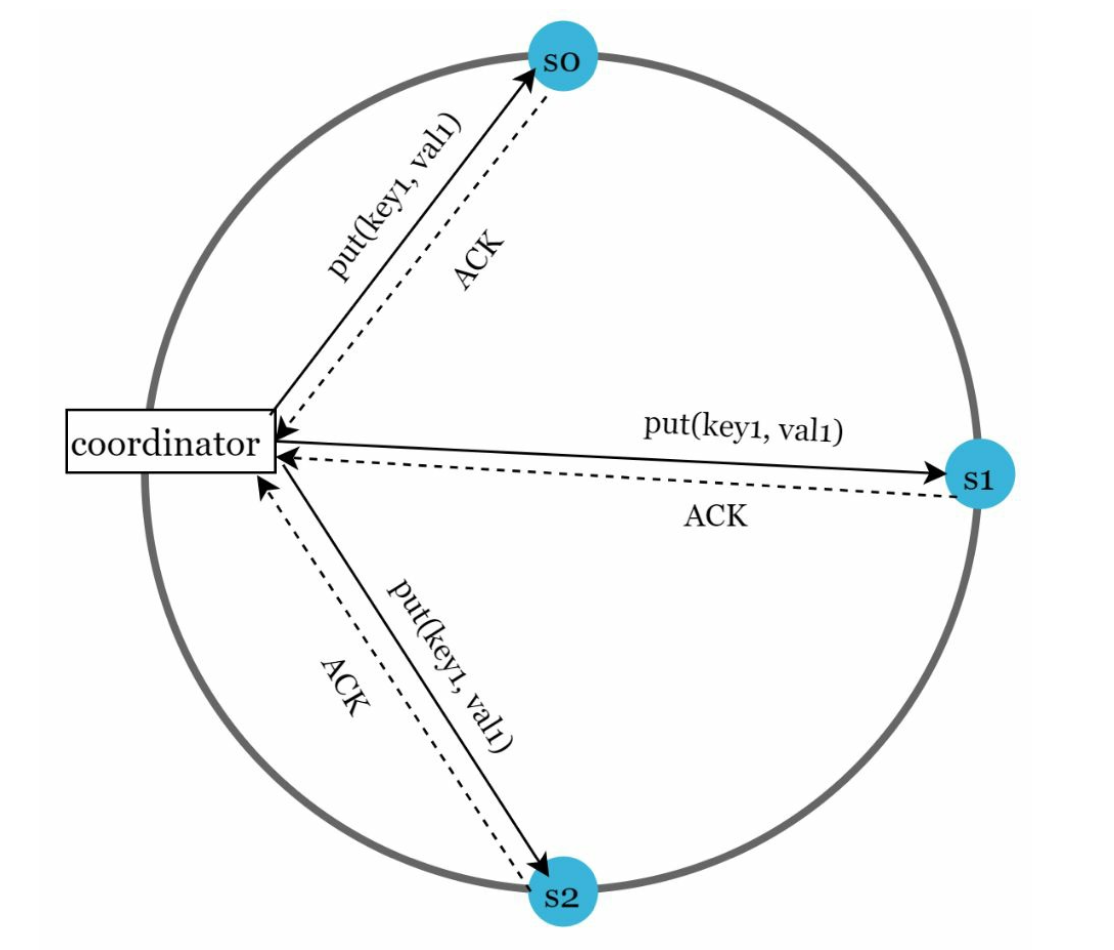
法定人数共识:
N:副本总数。W:写入法定人数。至少获得 W 个副本确认,写入才算成功。R:读取法定人数。至少等待 R 个副本响应,读取才算成功。规则:
W + R > N可以保证读写集合存在交集。W、R、N 的配置通常是在延迟与一致性之间权衡。
- 若 R = 1、W = N,系统偏向快速读取。
- 若 W = 1、R = N,系统偏向快速写入。
- 若 W + R > N,原文将其视为强一致性的保证(常用 N = 3、W = R = 2)。
- 若 W + R <= N,则无法保证强一致性。
一致性模型:
- 强一致性: 读取返回与最新写入结果对应的值。
- 弱一致性: 后续读取可能看不到最新值。
- 最终一致性: 经过足够时间,所有更新都会传播出去,副本最终趋于一致。
4. 解决数据不一致
数据复制提高了可用性,也可能导致副本间不一致。可以用版本控制和向量时钟处理冲突。
版本控制:
使用向量时钟跟踪数据版本并解决冲突。
每次修改都产生一个新的、不可变的数据版本。
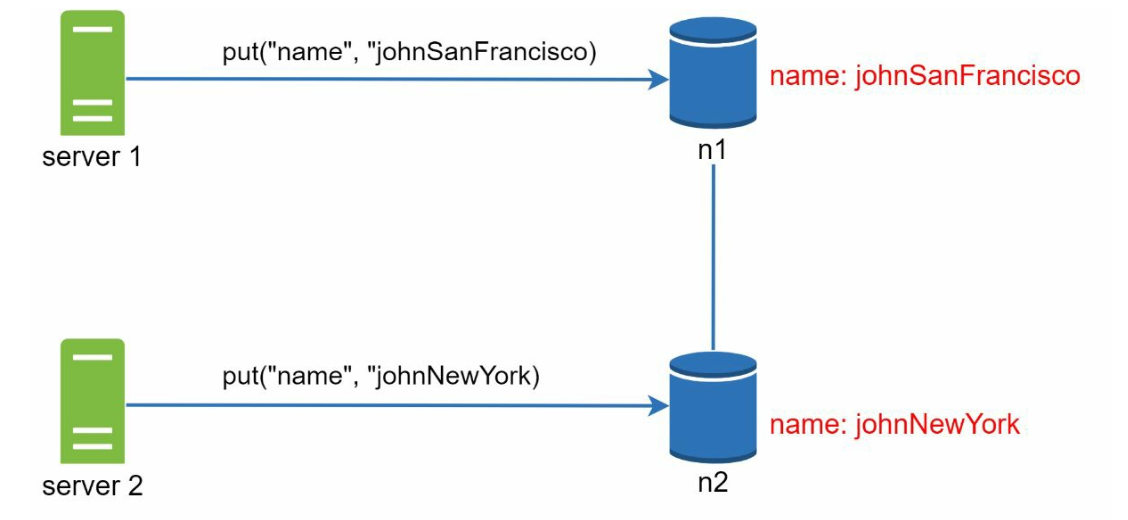
服务器 1 和服务器 2 同时修改名称,形成相互冲突的版本 v1 和 v2。
向量时钟
定义: 与数据项关联的向量时钟包含一组
[服务器, 版本号]。它可用来判断一个版本在另一个版本之前、之后,还是彼此冲突。- 假设数据项 D 的向量时钟为 D([S1, v1], [S2, v2], …, [Sn, vn]),当 D 写入服务器 Si 时,系统需要更新相应记录。
- 其中,
D是数据项,Si是服务器标识,vi是服务器Si上该数据的版本计数器。
更新向量时钟: 在服务器上修改数据项时:
- 若该服务器已在向量时钟中,其版本计数器加一。
- 否则,在向量时钟中新增该服务器的记录。
检测冲突:
- 无冲突: 若 X 中的所有计数器都小于或等于 Y 的对应计数器,则 X 是 Y 的祖先版本。
- 存在冲突: 若两个版本互不构成祖先关系,它们是并列版本,需要处理冲突。
解决冲突: 检测到并列版本后,系统依靠应用特定逻辑或客户端介入来合并数据。
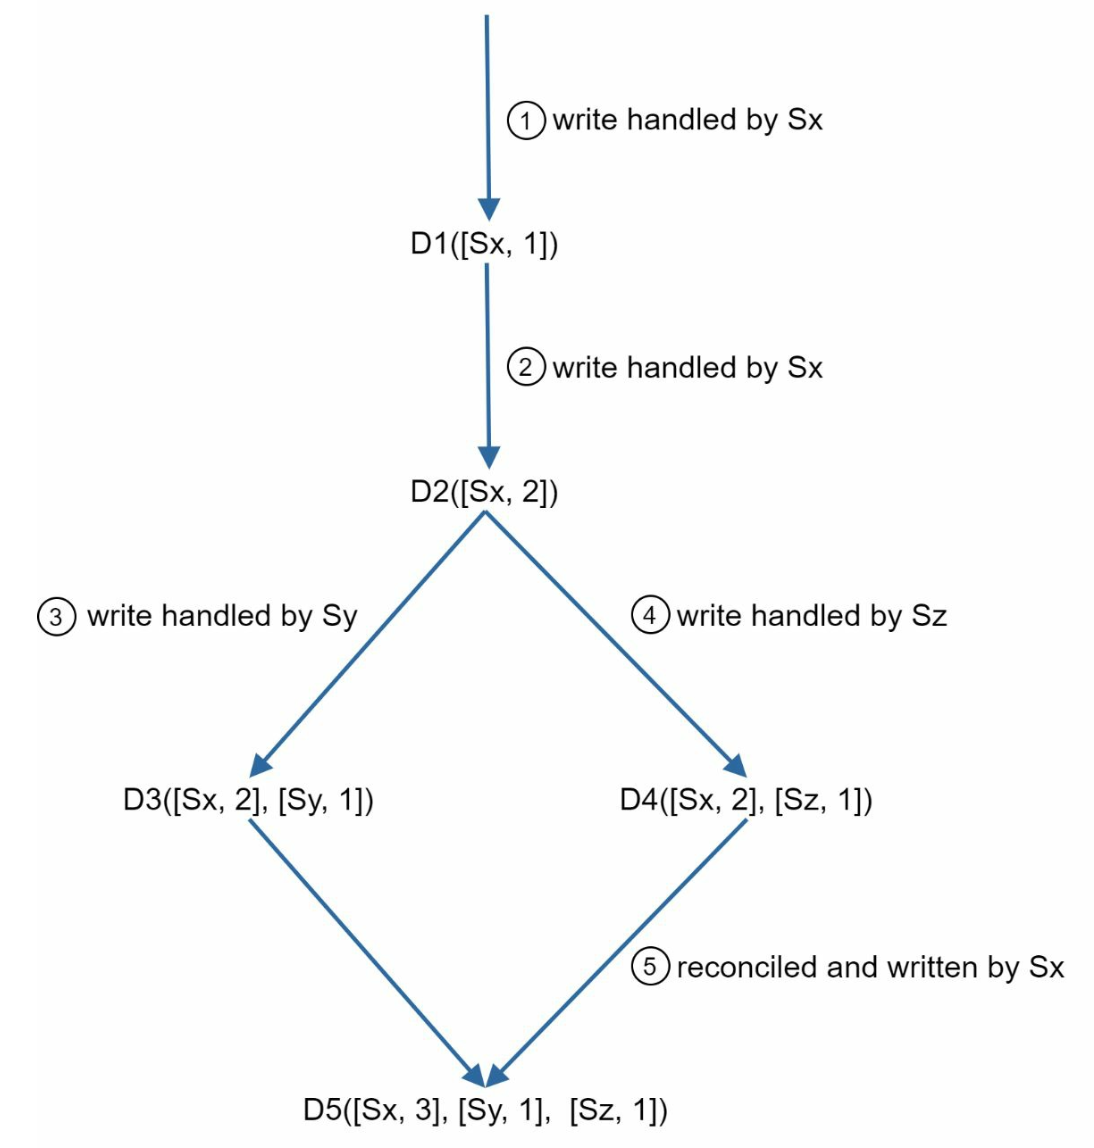
挑战:
- 客户端处理逻辑更加复杂。
- 更新和参与节点增多时,向量时钟可能变大,需要通过裁剪策略限制其大小。
5. 处理故障
a. 故障检测
不能仅凭另一台服务器的报告就断定某台服务器已故障。通常至少需要两个独立的信息来源。
Gossip 协议:
<img src="/images/chapter-06/gossip-protocol.png" alt="Gossip 协议" width="600" />- 每个节点维护成员 ID 和心跳计数器。
- 每个节点定期增加自己的心跳计数器。
- 每个节点定期向一组随机节点发送心跳。
- 如果某成员的心跳在预设时段内一直没有增加,就将其视为离线。
b. 临时故障
宽松法定人数: 暂时使用健康节点维持服务。
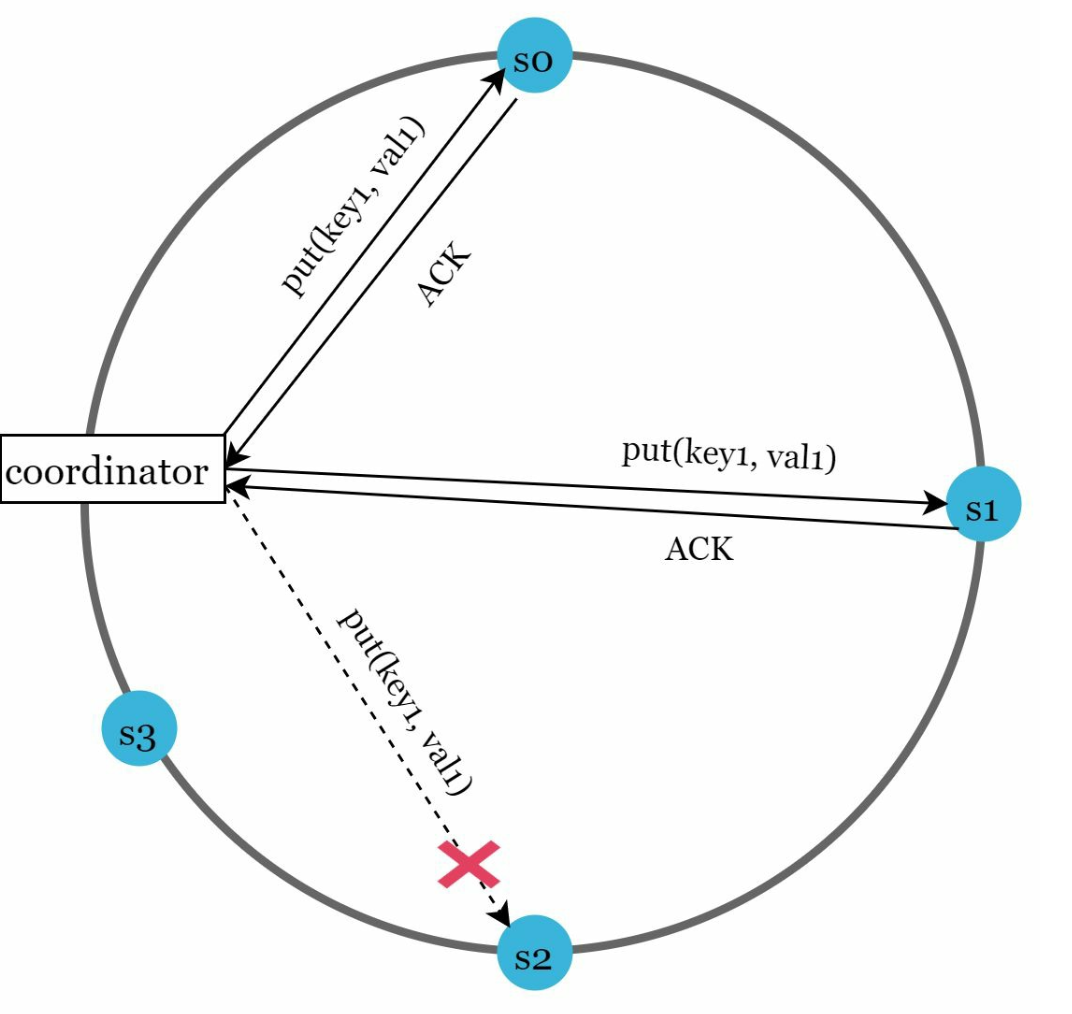
- 检测到故障后,系统需要采用机制保证可用性。
- 不严格限制在原定副本集合中,而是在哈希环上选择前 W 台健康服务器执行写入,选择前 R 台健康服务器执行读取。
- 跳过离线服务器,由其他服务器临时处理请求。
提示移交: 离线服务器恢复后补齐变更。
- 故障服务器恢复运行时,将暂存的变更传回,以实现数据一致。
c. 永久故障
使用 Merkle 树高效同步副本。 Merkle 树(哈希树)是一种数据结构,可在永久故障后高效找出并修复副本间的不一致。
工作方式
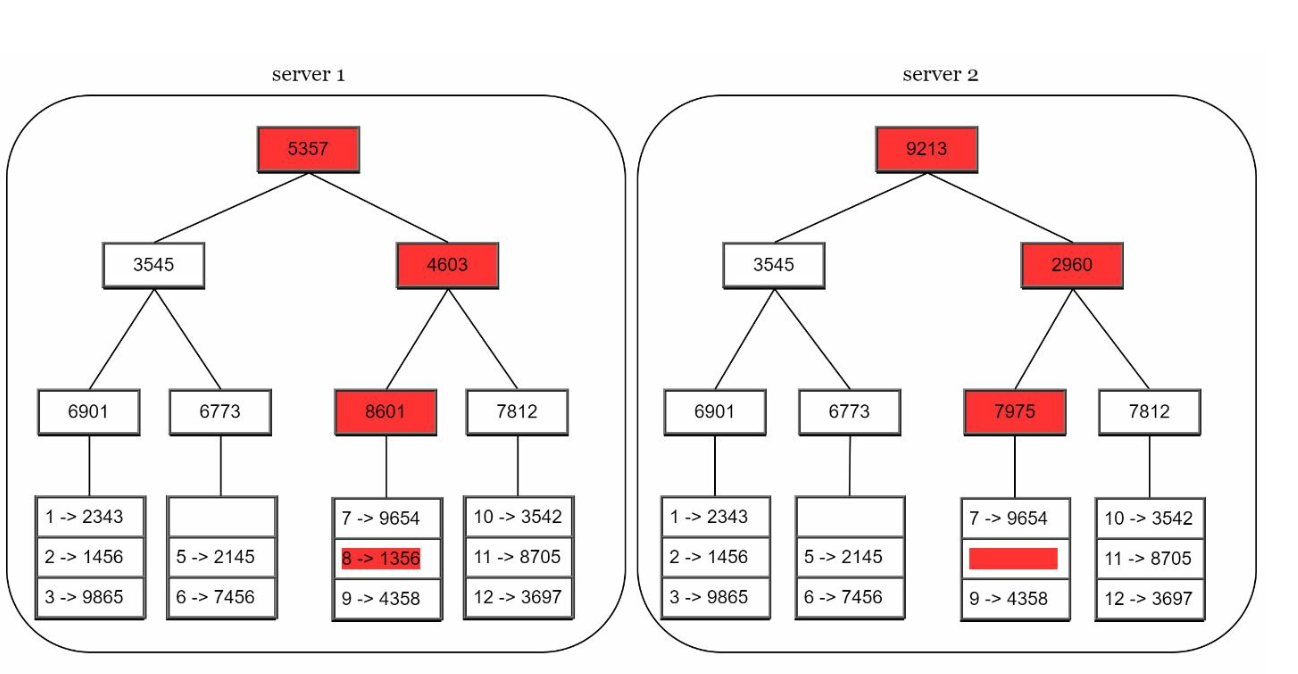
结构:
- 叶节点保存单个数据块的哈希值。
- 非叶节点保存其子节点哈希值计算出的哈希值。
- 根哈希表示整棵树中所有数据的组合状态。
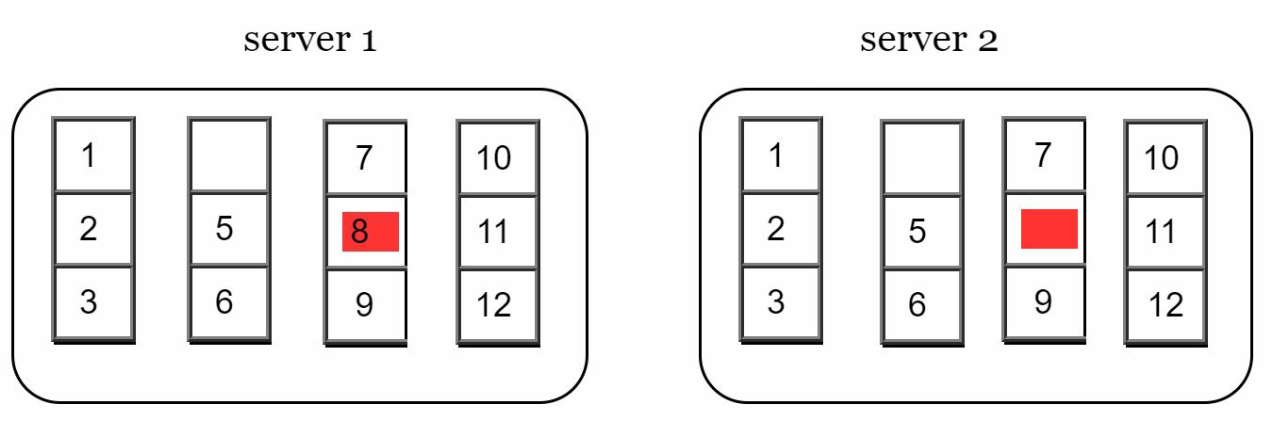
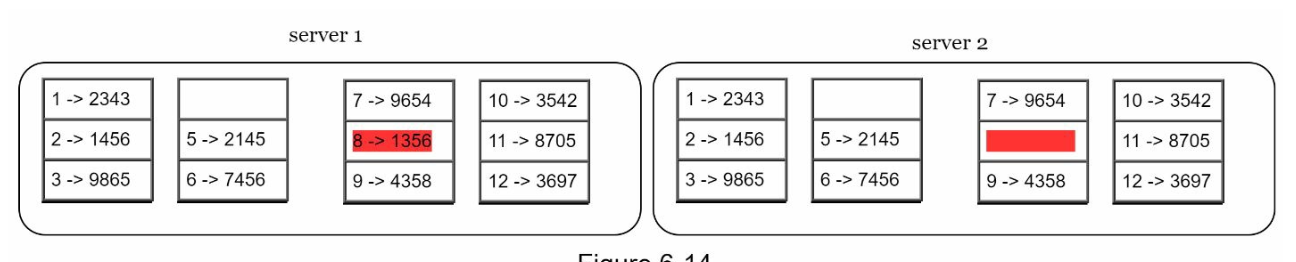
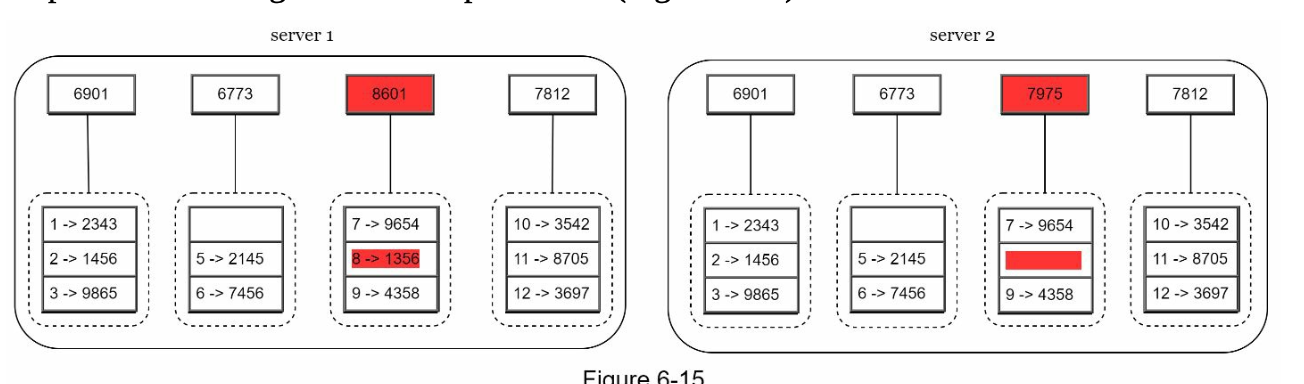
构建 Merkle 树:
第 1 步: 将键空间划分为桶。
第 2 步: 用均匀哈希计算桶中每个键的哈希值。
第 3 步: 为每个桶计算一个哈希值。
第 4 步: 逐层组合桶的哈希值,最终得到根哈希。
同步:
- 同步两个副本时:
- 比较根哈希。
- 根哈希相同则副本一致。
- 根哈希不同则递归比较子节点哈希,定位不一致的桶。
- 只同步不一致的数据。
- 同步两个副本时:
优点
- 效率: 只同步不一致的数据,减少传输量。
- 可扩展性: 适用于大型数据集,同步开销较低。
- 可靠性: 帮助保持副本之间的数据一致。
6. 处理数据中心故障
- 在多个数据中心复制数据,以便某个数据中心停机时继续提供服务。
写入与读取路径
1. 写入路径(基于 Cassandra 架构)
<img src="/images/chapter-06/write-path.png" alt="写入路径" width="500" />
- 将写入持久化到提交日志。
- 将数据保存到内存缓存。
- 缓存满时,将数据刷写到磁盘上的 SSTable(排序字符串表)。
2. 读取路径
<img src="/images/chapter-06/read-path.png"   alt="读取路径" width="500" />
<img src="/images/chapter-06/read-path-without-cache.png"   alt="缓存未命中的读取路径" width="500" />
- 先在内存缓存中查找数据。
- 如果没有找到,使用布隆过滤器定位数据所在的 SSTable。
- 读取并返回数据。
最终架构
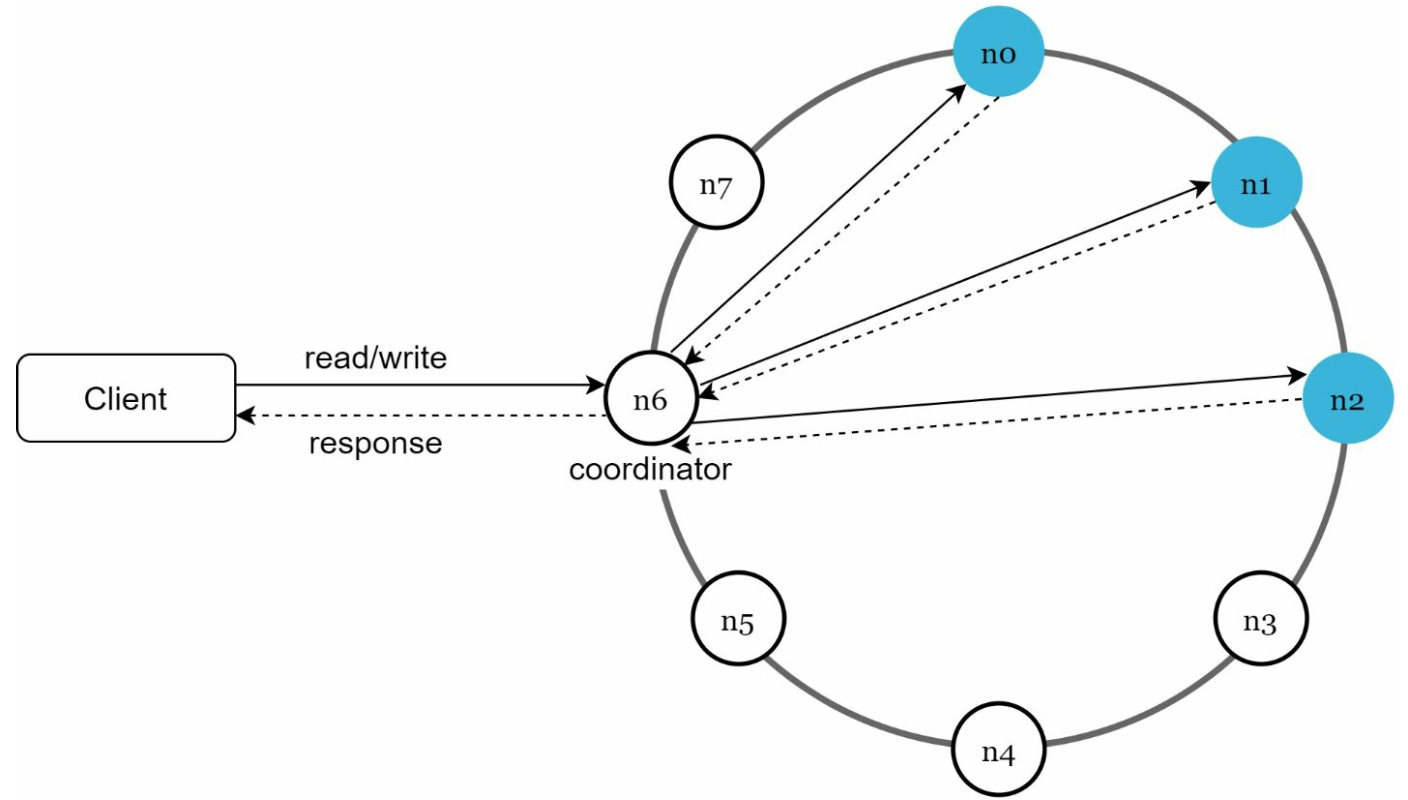
- 客户端通过简单 API 与键值存储通信:
get(key)和put(key, value)。 - 协调节点充当客户端与键值存储之间的代理。
- 通过一致性哈希将节点分布在环上。
- 系统完全去中心化,因此可以自动添加或迁移节点。
- 数据复制在多个节点上。
- 每个节点承担相同职责,因此没有单点故障。