第 19 章:分布式消息队列
引言
本章设计一个分布式消息队列。
消息队列的好处:
- 解耦:消除组件之间的紧密依赖,让它们独立更新。
- 提高可扩展性:可根据流量分别扩展生产者和消费者。
- 提高可用性:系统某一部分故障时,其他部分仍可与队列交互。
- 改善性能:生产者无需等待消费者确认,就能继续生产消息。
常见实现包括 Kafka、RabbitMQ、RocketMQ、Apache Pulsar、ActiveMQ 和 ZeroMQ。
严格来说,Kafka 和 Pulsar 是事件流平台,并非消息队列。不过,两类系统的功能逐渐融合,界限变得模糊。
本章设计的消息队列支持长期保留数据、重复消费消息等较高级的功能。
第 1 步:理解问题并确定设计范围
消息队列的基本功能是让生产者生产消息、消费者消费消息。但性能、消息投递和数据保留等方面仍有不同选择。
候选人与面试官可能会这样讨论:
- 候选人:消息是什么格式、平均多大?仅包含文本吗?
- 面试官:只有文本,通常为几 KB。
- 候选人:消息能重复消费吗?
- 面试官:能,不同消费者可以重复消费;这是传统消息队列不支持的额外需求。
- 候选人:消费顺序要与生产顺序一致吗?
- 面试官:是,需要保证顺序;这也是额外需求。
- 候选人:数据要保留多久?
- 面试官:两周;同样是额外需求。
- 候选人:需要支持多少生产者和消费者?
- 面试官:越多越好。
- 候选人:投递语义要支持至多一次、至少一次还是恰好一次?
- 面试官:至少要支持“至少一次”;最好全部支持,并且可配置。
- 候选人:吞吐量和端到端延迟有什么目标?
- 面试官:日志聚合等场景需要高吞吐量,传统场景则可能需要低延迟。
功能需求
- 生产者向消息队列发送消息。
- 消费者从队列消费消息。
- 消息可以消费一次或重复消费。
- 可以清理历史数据。
- 消息大小为 KB 级。
- 需要保持消息顺序。
- 投递语义可配置:至多一次、至少一次、恰好一次。
非功能需求
- 高吞吐量或低延迟:根据使用场景配置。
- 可扩展:系统应采用分布式架构,能应对消息量骤增。
- 持久性与耐久性:数据应写入磁盘,并在节点之间复制。
传统消息队列通常不保留数据,也不保证顺序,这会大幅简化设计;下文将讨论这些差异。
第 2 步:提出概要设计并达成共识
消息队列的关键组件:
<img src="/images/chapter-19/message-queue-components.png" alt="消息队列组件" width="500" />
- 生产者向队列发送消息。
- 消费者订阅队列并消费订阅的消息。
- 消息队列位于两者之间,使生产者与消费者解耦并独立扩展。
- 生产者和消费者都是客户端,消息队列是服务器。
消息传递模型
第一种是点对点模型,传统消息队列中很常见:
<img src="/images/chapter-19/point-to-point-model.png" alt="点对点模型" width="500" />
- 消息发送到队列后,由恰好一个消费者消费。
- 可以有多个消费者,但每条消息只消费一次。
- 消息确认已消费后,从队列移除。
- 点对点模型通常不保留数据,但本章的设计会保留。
另一种是发布/订阅模型,事件流平台更常使用:
<img src="/images/chapter-19/publish-subscribe-model.png" alt="发布订阅模型" width="500" />
- 消息归属于某个主题。
- 消费者订阅主题,接收发往该主题的全部消息。
主题、分区和 Broker
如果某个主题的数据量太大,可以将其拆成多个分区,也就是分片:
<img src="/images/chapter-19/partitions.png" alt="分区" width="500" />
- 发往主题的消息均匀分布到多个分区。
- 承载分区的服务器称为 Broker。
- 每个分区像 FIFO 队列一样处理消息;顺序在分区内得到保证。
- 消息在分区中的位置称为偏移量(offset)。
- 每条消息会进入特定分区;分区键决定目标分区。
- 例如,使用
user_id作为分区键,可保证同一用户的消息顺序。
- 例如,使用
- 每个消费者订阅一个或多个分区。若多个消费者协同处理同一批消息,它们组成消费者组。
消费者组
消费者组是一组协同消费某个主题消息的消费者:
<img src="/images/chapter-19/consumer-groups.png" alt="消费者组" width="500" />
- 消息按消费者组复制,而非按单个消费者复制。
- 每个消费者组维护自己的偏移量。
- 组内并行读取可以提高吞吐量,但可能破坏顺序保证。
- 限制同一分区在一个组内只由一位消费者订阅,可以缓解这个问题。
- 因此,一个组内的消费者数量不能超过分区数量。
概要架构
<img src="/images/chapter-19/high-level-architecture.png" alt="概要架构" width="500" />
- 客户端:包括生产者与消费者。生产者向指定主题发送消息,消费者组订阅主题消息。
- Broker:承载多个分区,每个分区存放主题的部分消息。
- 数据存储:存储各分区中的消息。
- 状态存储:保存消费者状态。
- 元数据存储:保存配置和主题属性。
- 协调服务:负责服务发现(哪些 Broker 存活)和选主(哪个 Broker 负责分配分区)。
第 3 步:深入设计
为实现高吞吐量和较长的数据保留期,设计中做出几项重要选择:
- 选择能利用现代 HDD 特性和操作系统磁盘缓存策略的磁盘数据结构。
- 消息数据结构不可变,以避免高流量场景中的额外复制。
- 围绕批量处理设计写入流程,因为大量小 I/O 会损害吞吐量。
数据存储
选择消息存储方式前,先看消息的特性:
- 读写量都很大。
- 不更新、不删除。传统消息队列因不保留消息而有“删除”操作。
- 主要采用顺序读写。
可选方案:
- 数据库:通常难以同时高效承担大量读写,并不理想。
- 预写日志(WAL):只支持追加的普通文件,很适合 HDD。
把分区拆为多个段,避免维护过大的单个文件。
旧段只读,仅向最新段写入。
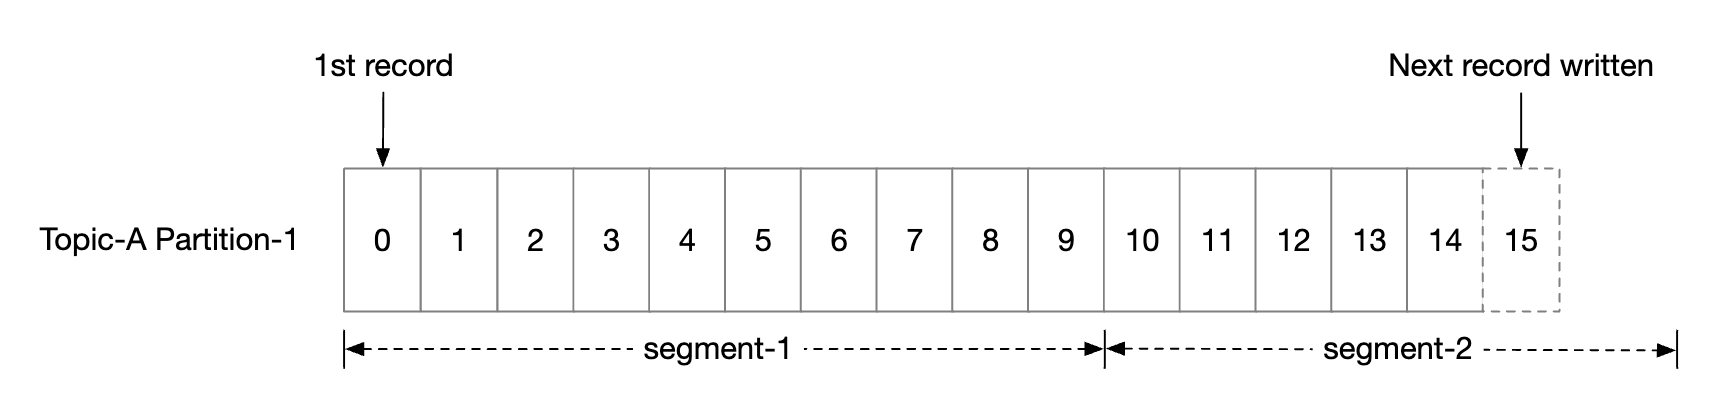
WAL 在传统 HDD 上非常高效。
认为 HDD 访问一定慢是个误解,实际速度高度依赖访问模式。顺序访问时,HDD 可达到每秒数 MB 的读写速度,足以满足本系统需求。操作系统还会积极把磁盘数据缓存到内存。
消息数据结构
生产者、队列和消费者应使用一致的消息结构,避免额外复制,从而提高处理效率。
消息结构示例:
<img src="/images/chapter-19/message-structure.png" alt="消息结构" width="500" />
消息键指定其所属分区,例如 hash(key) % numPartitions。生产者也可以覆盖默认键,控制消息分配到哪个分区。
消息值是载荷,可以是纯文本或压缩后的二进制块。
注意: 与传统键值存储不同,消息键无需唯一,可以重复,甚至可以缺失。
其他消息字段:
- 主题(Topic):消息所属的主题。
- 分区(Partition):消息所属分区的 ID。
- 偏移量(Offset):消息在分区中的位置,可用
topic、partition、offset定位消息。 - 时间戳(Timestamp):消息的存储时间。
- 大小(Size):消息大小。
- CRC:用于验证消息完整性的校验和。
可通过增加字段支持过滤等附加功能。
批量处理
批量处理对系统性能至关重要,应在生产者、消费者和消息队列中使用。
原因是:
- 操作系统可以合并消息,分摊昂贵的网络往返成本。
- 消息按组顺序写入 WAL,从而获得大量顺序写入及磁盘缓存收益。
延迟与吞吐量之间需要权衡:
- 批次越大,吞吐量越高,但延迟也越高。
- 批次越小,吞吐量越低,但延迟也越低。
若系统作为传统消息队列,需要较低延迟,就可以调小批次。
若系统针对吞吐量优化,则可能需要为每个主题增加分区,以弥补顺序磁盘写入速度的限制。
生产者流程
生产者向某个分区发送消息时,应连接哪台 Broker?
一种选择是增加路由层,由它将消息送到正确的 Broker。若启用了复制,目标 Broker 就是主副本所在的 Broker:
<img src="/images/chapter-19/routing-layer.png" alt="路由层" width="500" />
- 路由层从元数据存储读取副本分布计划,并在本地缓存。
- 生产者向路由层发送消息。
- 消息转发给该分区的主副本,即 Broker 1。
- 从副本向主副本拉取新消息。收到足够的确认后,主副本提交数据并回复生产者。
使用副本是为了容错。
这种方式可行,但有缺点:
- 额外的组件会增加网络跳数。
- 不便于对消息进行批量处理。
为解决这些问题,可以把路由层嵌入生产者:
<img src="/images/chapter-19/routing-layer-producer.png" alt="嵌入生产者的路由层" width="500" />
- 网络跳数减少,延迟降低。
- 生产者可控制消息进入哪个分区。
- 缓冲区让生产者在内存中组成批次,用一次请求发送更大的消息批,提高吞吐量。
批次大小是吞吐量与延迟之间的经典权衡。
<img src="/images/chapter-19/batch-size-throughput-vs-latency.png" alt="批次大小、吞吐量与延迟" width="500" />
- 批次越大,提交前等待越久。
- 批次越小,请求发送越早,延迟越低,但吞吐量也越低。
消费者流程
消费者指定某分区的偏移量,从该位置开始获取一批消息:
<img src="/images/chapter-19/consumer-example.png" alt="消费者示例" width="500" />
设计消费者时,一个重要选择是推送还是拉取:
- 推送模型:Broker 收到消息后主动推送给消费者,延迟较低。
- 但如果消费速度落后于生产速度,消费者可能被压垮。
- Broker 控制消费速度,难以适配处理能力不同的消费者。
- 拉取模型:消费者自行控制消费速度。
- 消费慢时不会被压垮,并可扩容追赶积压。
- 更适合批处理;推送模型下 Broker 不知道消费者一次能处理多少消息。
- 拉取模型中,消费者可以主动获取大量消息。
- 缺点是在没有新消息时延迟较高、产生额外网络请求;长轮询可缓解后者。
因此,多数消息队列(包括本设计)选择拉取模型。
<img src="/images/chapter-19/consumer-flow.png" alt="消费者流程" width="500" />
- 新消费者订阅主题 A,并加入组 1。
- 对组名做哈希,找到对应的 Broker 节点;同组消费者都连接该节点。
- 这里的消费者组协调器不同于 ZooKeeper 协调服务。
- 协调器确认消费者入组,并将分区 2 分配给它。
- 分区分配策略包括轮询、范围分配等。
- 消费者从上次偏移量开始获取最新消息。状态存储维护消费者偏移量。
- 消费者处理消息,并向 Broker 提交偏移量。两项操作的顺序决定消息投递语义。
消费者再均衡
再均衡决定每个分区由哪些消费者负责。
消费者加入、离开,或分区增加、移除时,都会触发再均衡。
作为协调器的 Broker 负责组织再均衡流程。
<img src="/images/chapter-19/consumer-rebalancing.png" alt="消费者再均衡" width="500" />
- 同组消费者连接同一个协调器;通过组名哈希找到协调器。
- 消费者列表变化后,协调器选择新的组负责人。
- 负责人计算新的分区分配计划并上报协调器,协调器再广播给其他消费者。
协调器长时间收不到组内消费者的心跳,也会触发再均衡:
<img src="/images/chapter-19/consumer-rebalance-example.png" alt="消费者再均衡示例" width="500" />
消费者入组时的流程:
<img src="/images/chapter-19/consumer-join-group-usecase.png" alt="消费者加入组" width="500" />
- 起初组内只有消费者 A,负责所有分区。
- 消费者 B 请求入组。
- 协调器通过对心跳的响应,通知所有组员开始再均衡。
- 所有消费者重新入组后,协调器选出负责人并公布结果。
- 负责人生成分区分配计划并发给协调器;其他消费者等待计划。
- 消费者开始从新分配的分区消费。
消费者离组时的流程:
<img src="/images/chapter-19/consumer-leaves-group-usecase.png" alt="消费者离开组" width="500" />
- 消费者 A、B 位于同一组。
- 消费者 B 请求离组。
- 协调器收到 A 的心跳时,通知它需要再均衡。
- 后续步骤与入组流程相同。
消费者长时间不发送心跳时,流程也类似:
<img src="/images/chapter-19/consumer-no-heartbeat-usecase.png" alt="消费者没有心跳" width="500" />
状态存储
状态存储保存分区与消费者的映射,以及每个分区最后消费的偏移量。
<img src="/images/chapter-19/state-storage.png" alt="状态存储" width="500" />
组 1 的偏移量为 6,表示此前的消息均已消费。消费者崩溃后,新的消费者将从该位置继续。
消费者状态的数据访问模式:
- 读写频繁,但数据量小。
- 更新频繁,删除很少。
- 随机读写。
- 对一致性要求较高。
因此,ZooKeeper 之类的快速键值存储很合适。
元数据存储
元数据存储保存配置和主题属性,包括分区数量、保留期限及副本分布。
元数据量小且变化不频繁,但需要强一致性,因此 ZooKeeper 是合适选择。
ZooKeeper
ZooKeeper 是构建分布式消息队列的重要组件。
它是层次化键值存储,常用于分布式配置、同步服务和命名注册(即服务发现)。
<img src="/images/chapter-19/zookeeper.png" alt="ZooKeeper" width="500" />
采用这一设计后,Broker 只需维护消息数据;元数据和状态由 ZooKeeper 保存。
ZooKeeper 还能协助 Broker 副本选主。
复制
分布式系统中硬件故障不可避免。通过复制可实现高可用性。
<img src="/images/chapter-19/replication-example.png" alt="复制示例" width="500" />
- 每个分区跨多个 Broker 复制,但只有一个主副本。
- 生产者向主副本发送消息。
- 从副本从主副本拉取消息。
- 足够多的副本完成同步后,主副本向生产者返回确认。
- 每个分区的副本分布称为副本分布计划。
- 给定分区的主副本制定分布计划,并存入 ZooKeeper。
同步副本
需要解决的问题是让一个分区的主副本与从副本保持同步。
同步副本(ISR)指与主副本保持同步的分区副本。
replica.lag.max.messages 定义副本最多可以落后主副本多少条消息,仍被视为同步。
<img src="/images/chapter-19/in-sync-replicas-example.png" alt="同步副本示例" width="500" />
- 已提交偏移量为 13。
- 两条新消息已写入主副本,但尚未提交。
- ISR 中所有副本都同步某条消息后,该消息才会提交。
- 副本 2、3 已追上主副本,因此属于 ISR。
- 副本 4 已落后,因此暂时从 ISR 移除。
ISR 体现了性能与耐久性之间的权衡:
- 若要防止生产者丢失消息,发送确认前应确保所有副本同步。
- 但缓慢的副本可能使整个分区不可用。
确认策略可配置。
ACK=all 表示 ISR 内所有副本都必须同步消息;发送较慢,但耐久性最高。
<img src="/images/chapter-19/ack-all.png" alt="ACK=all" width="500" />
ACK=1 表示主副本收到消息后,生产者就获得确认;发送较快,但耐久性较低。
<img src="/images/chapter-19/ack-1.png" alt="ACK=1" width="500" />
ACK=0 表示生产者发送消息后不等待主副本确认;发送最快,但耐久性最低。
<img src="/images/chapter-19/ack-0.png" alt="ACK=0" width="500" />
在消费者侧,可以让所有消费者连接分区主副本并从中读取:
- 设计和运维最简单。
- 一个分区的消息在每组中只发送给一个消费者,因此主副本连接数有限。
- 只要主题不是极热,主副本连接数通常不会太高。
- 可以增加分区和消费者数量来扩展热门主题。
- 某些情况下可允许消费者从 ISR 读取,例如消费者位于另一数据中心时。
主副本跟踪自己与各副本之间的滞后,维护 ISR 列表。
可扩展性
下面评估系统各部分的扩展方式。
生产者
生产者比消费者简单得多。增加或移除生产者实例即可扩缩容。
消费者
消费者组彼此隔离,可以按需增加或移除。
消费者加入或离组时,再均衡机制可以妥善处理。
消费者组及其再均衡机制为系统提供可扩展性和容错能力。
Broker
Broker 故障如何处理?
<img src="/images/chapter-19/broker-failure-recovery.png" alt="Broker 故障恢复" width="500" />
- 一台 Broker 故障后,其他副本仍能避免分区数据丢失。
- 选出新主副本,Broker 协调器把故障 Broker 的分区重新分配给现有副本。
- 现有副本接管新分区并作为从副本运行,直到追上主副本并加入 ISR。
增强 Broker 容错能力还要考虑:
- ISR 最小数量在延迟和安全性之间权衡,可按需求调整。
- 若一个分区的全部副本都在同一节点,复制就失去意义;应分布到不同 Broker。
- 如果分区的全部副本都崩溃,数据将永久丢失。跨数据中心分布副本可缓解,但会显著增加延迟。可考虑使用数据镜像。
增加新 Broker 时,如何重新分配副本?
<img src="/images/chapter-19/broker-replica-redistribution.png" alt="Broker 副本重新分配" width="500" />
- 新 Broker 追上进度前,可暂时允许副本数量超过配置值。
- 追上后再移除不再需要的分区副本。
分区
新增分区时,通知生产者并触发消费者再均衡。
存储方面,可以让新分区只接收新消息,不复制全部历史消息:
<img src="/images/chapter-19/partition-exmaple.png" alt="分区示例" width="500" />
减少分区数量更复杂:
<img src="/images/chapter-19/partition-decrease.png" alt="减少分区" width="500" />
- 分区停用后,新消息只进入其余分区。
- 停用的分区不会立刻删除,因为仍可能有消息需要消费。
- 预设保留期限过后,清理数据并释放存储空间。
- 过渡期内,生产者只向活跃分区发送消息,消费者则读取所有分区。
- 保留期限届满后,对消费者再均衡。
数据投递语义
下面讨论不同的投递语义。
至多一次
消息最多投递一次,也可能完全没有投递。
<img src="/images/chapter-19/at-most-once.png" alt="至多一次" width="500" />
- 生产者异步向主题发送消息;投递失败也不重试。
- 消费者获取消息后立即提交偏移量。如果处理前崩溃,消息就不会被处理。
至少一次
消息可能投递多次,但不应有消息未被处理。
<img src="/images/chapter-19/at-least-once.png" alt="至少一次" width="500" />
- 生产者以
ack=1或ack=all发送消息,发生问题则持续重试。 - 消费者获取消息,处理完成后才提交偏移量。
- 若消费者处理完消息、提交偏移量前崩溃,消息可能重复投递。
- 因此,它适用于允许重复数据或可执行去重的场景。
恰好一次
这是对用户最友好的保证,但在系统中实现的成本极高:
<img src="/images/chapter-19/exactly-once.png" alt="恰好一次" width="500" />
高级功能
下面讨论面试中可能涉及的高级功能。
消息过滤
有些消费者只希望接收分区内某种类型的消息。
可以为不同消息子集分别建主题,但如果使用场景很多,成本会很高:
- 同一消息存放在不同主题,浪费资源。
- 每增加一种消费者需求,生产者都要改动,造成紧密耦合。
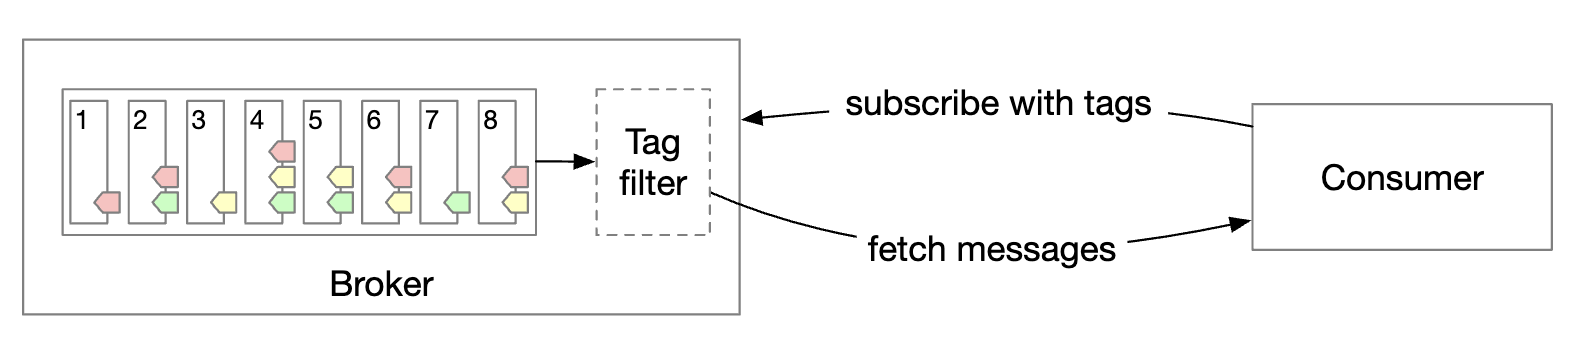
可以用消息过滤解决:
最简单的办法是在消费者侧过滤,但会带来不必要的传输。
也可以给消息附加标签,由消费者指定订阅哪些标签。
还可以按消息载荷过滤,但对于加密或序列化的消息,这可能困难且不安全。
对复杂数学表达式,Broker 可实现语法解析器或脚本执行器,但会让消息队列过于沉重。
延迟消息与定时消息
有些场景需要延迟或定时投递。例如,安排 30 分钟后检查一次付款,让消费者确认付款是否成功。
可以先把消息放入 Broker 的临时存储,再在指定时间将其移入分区:
<img src="/images/chapter-19/delayed-message-implementation.png" alt="延迟消息实现" width="500" />
- 临时存储可以是一个或多个特殊消息主题。
- 计时功能可用专用延迟队列或分层时间轮实现。
第 4 步:总结
还可讨论以下内容:
- 通信协议:应支持全部使用场景和高数据量,并能验证消息完整性。常见协议包括 AMQP 和 Kafka 协议。
- 消费重试:若消息暂时无法处理,可将其送入专用重试主题,稍后再次尝试。
- 历史数据归档:旧消息可以备份到 HDFS 或对象存储(例如 S3)等大容量存储中。